mirror of
https://github.com/agentscope-ai/ReMe.git
synced 2026-10-08 03:10:24 +00:00
up
This commit is contained in:
 jinli.yl
parent
8196655479
commit
faec58f984
6 changed files with 814 additions and 2391 deletions
748
README.md
748
README.md
|
|
@ -1,717 +1,41 @@
|
|||
<p align="center">
|
||||
<img src="docs/_static/figure/reme_logo.png" alt="ReMe Logo" width="50%">
|
||||
</p>
|
||||
<div align="center">
|
||||
<img src="docs/figure/reme_logo.png" alt="ReMe Logo" width="420">
|
||||
|
||||
<h3>Remember Me, Refine Me</h3>
|
||||
<p>
|
||||
<strong>A memory management toolkit for AI agents.</strong>
|
||||
</p>
|
||||
|
||||
<p>
|
||||
<a href="https://pypi.org/project/reme-ai/"><img src="https://img.shields.io/badge/python-3.11+-3776AB?logo=python&logoColor=white" alt="Python Version"></a>
|
||||
<a href="https://pypi.org/project/reme-ai/"><img src="https://img.shields.io/pypi/v/reme-ai.svg?logo=pypi&logoColor=white" alt="PyPI Version"></a>
|
||||
<a href="https://pepy.tech/project/reme-ai/"><img src="https://img.shields.io/pypi/dm/reme-ai?color=2ea44f" alt="PyPI Downloads"></a>
|
||||
<a href="https://github.com/agentscope-ai/ReMe"><img src="https://img.shields.io/github/commit-activity/m/agentscope-ai/ReMe?color=7c3aed" alt="GitHub commit activity"></a>
|
||||
<a href="./LICENSE"><img src="https://img.shields.io/badge/license-Apache--2.0-111827" alt="License"></a>
|
||||
</p>
|
||||
|
||||
<p>
|
||||
<a href="./README.md">English</a>
|
||||
·
|
||||
<a href="./README_old.md">简体中文</a>
|
||||
·
|
||||
<a href="https://deepwiki.com/agentscope-ai/ReMe">DeepWiki</a>
|
||||
·
|
||||
<a href="https://github.com/agentscope-ai/ReMe">GitHub</a>
|
||||
</p>
|
||||
|
||||
<p>
|
||||
<a href="https://github.com/agentscope-ai/ReMe"><img src="https://img.shields.io/github/stars/agentscope-ai/ReMe?style=social" alt="GitHub Stars"></a>
|
||||
<a href="https://trendshift.io/repositories/20528" target="_blank"><img src="https://trendshift.io/api/badge/repositories/20528" alt="agentscope-ai/ReMe | Trendshift" width="220" height="48"></a>
|
||||
</p>
|
||||
</div>
|
||||
|
||||
<p align="center">
|
||||
<a href="https://pypi.org/project/reme-ai/"><img src="https://img.shields.io/badge/python-3.10+-blue" alt="Python Version"></a>
|
||||
<a href="https://pypi.org/project/reme-ai/"><img src="https://img.shields.io/pypi/v/reme-ai.svg?logo=pypi" alt="PyPI Version"></a>
|
||||
<a href="https://pepy.tech/project/reme-ai/"><img src="https://img.shields.io/pypi/dm/reme-ai" alt="PyPI Downloads"></a>
|
||||
<a href="https://github.com/agentscope-ai/ReMe"><img src="https://img.shields.io/github/commit-activity/m/agentscope-ai/ReMe?style=flat-square" alt="GitHub commit activity"></a>
|
||||
<a href="https://github.com/agentscope-ai/ReMe/tree/v0.3.1.10">0.3.x</a>
|
||||
·
|
||||
<a href="https://github.com/agentscope-ai/ReMe/tree/v0.2.0.6">0.2.x</a>
|
||||
·
|
||||
<a href="https://github.com/agentscope-ai/ReMe/tree/memoryscope_branch">memoryscope</a>
|
||||
</p>
|
||||
|
||||
<p align="center">
|
||||
<a href="./LICENSE"><img src="https://img.shields.io/badge/license-Apache--2.0-black" alt="License"></a>
|
||||
<a href="./README.md"><img src="https://img.shields.io/badge/English-Click-yellow" alt="English"></a>
|
||||
<a href="./README_ZH.md"><img src="https://img.shields.io/badge/简体中文-点击查看-orange" alt="简体中文"></a>
|
||||
<a href="https://github.com/agentscope-ai/ReMe"><img src="https://img.shields.io/github/stars/agentscope-ai/ReMe?style=social" alt="GitHub Stars"></a>
|
||||
<a href="https://deepwiki.com/agentscope-ai/ReMe"><img src="https://img.shields.io/badge/DeepWiki-Ask_Devin-navy.svg" alt="DeepWiki"></a>
|
||||
</p>
|
||||
|
||||
<p align="center">
|
||||
<a href="https://trendshift.io/repositories/20528" target="_blank"><img src="https://trendshift.io/api/badge/repositories/20528" alt="agentscope-ai%2FReMe | Trendshift" style="width: 250px; height: 55px;" width="250" height="55"/></a>
|
||||
</p>
|
||||
|
||||
<p align="center">
|
||||
<strong>A memory management toolkit for AI agents — Remember Me, Refine Me.</strong><br>
|
||||
</p>
|
||||
|
||||
> For the older version, please refer to the [0.2.x documentation](docs/README_0_2_x.md).
|
||||
|
||||
---
|
||||
|
||||
## 📰 Latest Articles
|
||||
|
||||
| Date | Title |
|
||||
|------------|-----------------------------------------------------------------|
|
||||
| 2026-03-30 | [Context Management Design](docs/copaw_context_design.md) |
|
||||
|
||||
---
|
||||
|
||||
🧠 ReMe is a memory management framework designed for **AI agents**, providing
|
||||
both [file-based](#-file-based-memory-system-remelight) and [vector-based](#-vector-based-memory-system) memory systems.
|
||||
|
||||
It tackles two core problems of agent memory: **limited context window** (early information is truncated or lost in long
|
||||
conversations) and **stateless sessions** (new sessions cannot inherit history and always start from scratch).
|
||||
|
||||
ReMe gives agents **real memory** — old conversations are automatically compacted, important information is persistently
|
||||
stored, and relevant context is automatically recalled in future interactions.
|
||||
|
||||
ReMe achieves state-of-the-art results on the LoCoMo and HaluMem benchmarks; see the [Experimental results](#experimental-results).
|
||||
|
||||
<details>
|
||||
<summary><b>What you can do with ReMe</b></summary>
|
||||
|
||||
<br>
|
||||
|
||||
- **Personal assistant**: Provide long-term memory for agents like [QwenPaw](https://github.com/agentscope-ai/CoPaw),
|
||||
remembering user preferences and conversation history.
|
||||
- **Coding assistant**: Record code style preferences and project context, maintaining a consistent development
|
||||
experience across sessions.
|
||||
- **Customer service bot**: Track user issue history and preference settings for personalized service.
|
||||
- **Task automation**: Learn success/failure patterns from historical tasks to continuously optimize execution
|
||||
strategies.
|
||||
- **Knowledge Q&A**: Build a searchable knowledge base with semantic search and exact matching support.
|
||||
- **Multi-turn dialogue**: Automatically compress long conversations while retaining key information within limited
|
||||
context windows.
|
||||
|
||||
</details>
|
||||
|
||||
---
|
||||
|
||||
## 📁 File-based memory system (ReMeLight)
|
||||
|
||||
> Memory as files, files as memory.
|
||||
|
||||
Treat **memory as files** — readable, editable, and copyable.
|
||||
[QwenPaw](https://github.com/agentscope-ai/CoPaw) integrates long-term memory and context management by inheriting from
|
||||
`ReMeLight`.
|
||||
|
||||
| Traditional memory system | File-based ReMe |
|
||||
|---------------------------|----------------------|
|
||||
| 🗄️ Database storage | 📝 Markdown files |
|
||||
| 🔒 Opaque | 👀 Always readable |
|
||||
| ❌ Hard to modify | ✏️ Directly editable |
|
||||
| 🚫 Hard to migrate | 📦 Copy to migrate |
|
||||
|
||||
```
|
||||
working_dir/
|
||||
├── MEMORY.md # Long-term memory: persistent info such as user preferences
|
||||
├── memory/
|
||||
│ └── YYYY-MM-DD.md # Daily journal: automatically written after each conversation
|
||||
├── dialog/ # Raw conversation records: full dialog before compression
|
||||
│ └── YYYY-MM-DD.jsonl # Daily conversation messages in JSONL format
|
||||
└── tool_result/ # Cache for long tool outputs (auto-managed, expired entries auto-cleaned)
|
||||
└── <uuid>.txt
|
||||
```
|
||||
|
||||
### Core capabilities
|
||||
|
||||
[ReMeLight](reme/reme_light.py) is the core class of the file-based memory system. It provides full memory management
|
||||
capabilities for AI agents:
|
||||
|
||||
<table>
|
||||
<tr><th>Category</th><th>Method</th><th>Function</th><th>Key components</th></tr>
|
||||
<tr><td rowspan="4">Context Management</td><td><code>check_context</code></td><td>📊 Check context size</td><td><a href="reme/memory/file_based/components/context_checker.py">ContextChecker</a> — checks whether context exceeds thresholds and splits messages</td></tr>
|
||||
<tr><td><code>compact_memory</code></td><td>📦 Compact history into summary</td><td><a href="reme/memory/file_based/components/compactor.py">Compactor</a> — ReActAgent that generates structured context summaries</td></tr>
|
||||
<tr><td><code>compact_tool_result</code></td><td>✂️ Compact long tool outputs</td><td><a href="reme/memory/file_based/components/tool_result_compactor.py">ToolResultCompactor</a> — truncates long tool outputs and stores them in <code>tool_result/</code> while keeping file references in messages</td></tr>
|
||||
<tr><td><code>pre_reasoning_hook</code></td><td>🔄 Pre-reasoning hook</td><td><code>compact_tool_result</code> + <code>check_context</code> + <code>compact_memory</code> + <code>summary_memory</code> (async)</td></tr>
|
||||
<tr><td rowspan="2">Long-term Memory</td><td><code>summary_memory</code></td><td>📝 Persist important memory to files</td><td><a href="reme/memory/file_based/components/summarizer.py">Summarizer</a> — ReActAgent + file tools (<code>read</code> / <code>write</code> / <code>edit</code>)</td></tr>
|
||||
<tr><td><code>memory_search</code></td><td>🔍 Semantic memory search</td><td><a href="reme/memory/file_based/tools/memory_search.py">MemorySearch</a> — hybrid retrieval with vectors + BM25</td></tr>
|
||||
<tr><td rowspan="2">Session Memory</td><td><code>get_in_memory_memory</code></td><td>💾 Create in-session memory instance</td><td>Returns ReMeInMemoryMemory with dialog_path configured for persistence</td></tr>
|
||||
<tr><td><code>await_summary_tasks</code></td><td>⏳ Wait for async summary tasks</td><td>Block until all background summary tasks complete</td></tr>
|
||||
<tr><td>-</td><td><code>start</code></td><td>🚀 Start memory system</td><td>Initialize file storage, file watcher, and embedding cache; clean up expired tool result files</td></tr>
|
||||
<tr><td>-</td><td><code>close</code></td><td>📕 Shutdown and cleanup</td><td>Clean up tool result files, stop file watcher, and persist embedding cache</td></tr>
|
||||
</table>
|
||||
|
||||
---
|
||||
|
||||
### 🚀 Quick start
|
||||
|
||||
#### Installation
|
||||
|
||||
**Install from source:**
|
||||
|
||||
```bash
|
||||
git clone https://github.com/agentscope-ai/ReMe.git
|
||||
cd ReMe
|
||||
pip install -e ".[light]"
|
||||
```
|
||||
|
||||
**Update to the latest version:**
|
||||
|
||||
```bash
|
||||
git pull
|
||||
pip install -e ".[light]"
|
||||
```
|
||||
|
||||
#### Environment variables
|
||||
|
||||
`ReMeLight` uses environment variables to configure the embedding model and storage backends:
|
||||
|
||||
| Variable | Description | Example |
|
||||
|----------------------|-------------------------------|-----------------------------------------------------|
|
||||
| `LLM_API_KEY` | LLM API key | `sk-xxx` |
|
||||
| `LLM_BASE_URL` | LLM base URL | `https://dashscope.aliyuncs.com/compatible-mode/v1` |
|
||||
| `EMBEDDING_API_KEY` | Embedding API key (optional) | `sk-xxx` |
|
||||
| `EMBEDDING_BASE_URL` | Embedding base URL (optional) | `https://dashscope.aliyuncs.com/compatible-mode/v1` |
|
||||
|
||||
#### Python usage
|
||||
|
||||
```python
|
||||
import asyncio
|
||||
|
||||
from reme.reme_light import ReMeLight
|
||||
|
||||
|
||||
async def main():
|
||||
# Initialize ReMeLight
|
||||
reme = ReMeLight(
|
||||
default_as_llm_config={"model_name": "qwen3.5-35b-a3b"},
|
||||
# default_embedding_model_config={"model_name": "text-embedding-v4"},
|
||||
default_file_store_config={"fts_enabled": True, "vector_enabled": False},
|
||||
enable_load_env=True,
|
||||
)
|
||||
await reme.start()
|
||||
|
||||
messages = [...] # List of conversation messages
|
||||
|
||||
# 1. Check context size (token counting, determine if compaction is needed)
|
||||
messages_to_compact, messages_to_keep, is_valid = await reme.check_context(
|
||||
messages=messages,
|
||||
memory_compact_threshold=90000, # Threshold to trigger compaction (tokens)
|
||||
memory_compact_reserve=10000, # Token count to reserve for recent messages
|
||||
)
|
||||
|
||||
# 2. Compact conversation history into a structured summary
|
||||
summary = await reme.compact_memory(
|
||||
messages=messages,
|
||||
previous_summary="",
|
||||
max_input_length=128000, # Model context window (tokens)
|
||||
compact_ratio=0.7, # Trigger compaction when exceeding max_input_length * 0.7
|
||||
language="zh", # Summary language (e.g., "zh" / "")
|
||||
)
|
||||
|
||||
# 3. Compact long tool outputs (prevent tool results from blowing up context)
|
||||
messages = await reme.compact_tool_result(messages)
|
||||
|
||||
# 4. Pre-reasoning hook (auto compact tool results + check context + generate summaries)
|
||||
processed_messages, compressed_summary = await reme.pre_reasoning_hook(
|
||||
messages=messages,
|
||||
system_prompt="You are a helpful AI assistant.",
|
||||
compressed_summary="",
|
||||
max_input_length=128000,
|
||||
compact_ratio=0.7,
|
||||
memory_compact_reserve=10000,
|
||||
enable_tool_result_compact=True,
|
||||
tool_result_compact_keep_n=3,
|
||||
)
|
||||
|
||||
# 5. Persist important memory to files (writes to memory/YYYY-MM-DD.md)
|
||||
summary_result = await reme.summary_memory(
|
||||
messages=messages,
|
||||
language="zh",
|
||||
)
|
||||
|
||||
# 6. Semantic memory search (vector + BM25 hybrid retrieval)
|
||||
result = await reme.memory_search(query="Python version preference", max_results=5)
|
||||
|
||||
# 7. Create in-session memory instance (manages context for one conversation)
|
||||
memory = reme.get_in_memory_memory() # Auto-configures dialog_path
|
||||
for msg in messages:
|
||||
await memory.add(msg)
|
||||
token_stats = await memory.estimate_tokens(max_input_length=128000)
|
||||
print(f"Current context usage: {token_stats['context_usage_ratio']:.1f}%")
|
||||
print(f"Message token count: {token_stats['messages_tokens']}")
|
||||
print(f"Estimated total tokens: {token_stats['estimated_tokens']}")
|
||||
|
||||
# 8. Mark messages as compressed (auto-persists to dialog/YYYY-MM-DD.jsonl)
|
||||
# await memory.mark_messages_compressed(messages_to_compact)
|
||||
|
||||
# Shutdown ReMeLight
|
||||
await reme.close()
|
||||
|
||||
|
||||
if __name__ == "__main__":
|
||||
asyncio.run(main())
|
||||
```
|
||||
|
||||
> 📂 Full example: [test_reme_light.py](tests/light/test_reme_light.py)
|
||||
> 📋 Sample run log: [test_reme_light_log.txt](tests/light/test_reme_light_log.txt) (223,838 tokens → 1,105 tokens, 99.5%
|
||||
> compression)
|
||||
|
||||
### Architecture of the file-based ReMeLight memory system
|
||||
|
||||
#### Context data structure
|
||||
|
||||
```mermaid
|
||||
flowchart TD
|
||||
A[Context] --> B[compact_summary]
|
||||
B --> C[dialog path guide + Goal/Constraints/Progress/KeyDecisions/NextSteps]
|
||||
A --> E[messages: full dialogue history]
|
||||
A --> F[File System Cache]
|
||||
F --> G[dialog/YYYY-MM-DD.jsonl]
|
||||
F --> H[tool_result/uuid.txt N-day TTL]
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
[MemoryManager](https://github.com/agentscope-ai/CoPaw/blob/main/src/copaw/agents/memory/reme_light_memory_manager.py)
|
||||
inherits `ReMeLight` and integrates its memory capabilities into the agent reasoning loop:
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
Agent[Agent] -->|Before each reasoning step| Hook[pre_reasoning_hook]
|
||||
Hook --> TC[compact_tool_result<br>Compact tool outputs]
|
||||
TC --> CC[check_context<br>Token counting]
|
||||
CC -->|Exceeds limit| CM[compact_memory<br>Generate summary]
|
||||
CC -->|Exceeds limit| SM[summary_memory<br>Async persistence]
|
||||
SM -->|ReAct + FileIO| Files[memory/*.md]
|
||||
CC -->|Exceeds limit| MMC[mark_messages_compressed<br>Persist raw dialog]
|
||||
MMC --> Dialog[dialog/*.jsonl]
|
||||
Agent -->|Explicit call| Search[memory_search<br>Vector+BM25]
|
||||
Agent -->|In - session| InMem[ReMeInMemoryMemory<br>Token-aware memory]
|
||||
InMem -->|Compress/Clear| Dialog
|
||||
Files -.->|FileWatcher| Store[(FileStore<br>Vector+FTS index)]
|
||||
Search --> Store
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
#### 1. `check_context` — context checking
|
||||
|
||||
[ContextChecker](reme/memory/file_based/components/context_checker.py) uses token counting to determine whether the
|
||||
context exceeds thresholds and automatically splits messages into a "to compact" group and a "to keep" group.
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
M[messages] --> H[AsMsgHandler<br>Token counting]
|
||||
H --> C{total > threshold?}
|
||||
C -->|No| K[Return all messages]
|
||||
C -->|Yes| S[Keep from tail<br>reserve tokens]
|
||||
S --> CP[messages_to_compact<br>Earlier messages]
|
||||
S --> KP[messages_to_keep<br>Recent messages]
|
||||
S --> V{is_valid<br>Tool calls aligned?}
|
||||
```
|
||||
|
||||
- **Core logic**: keep `reserve` tokens from the tail; mark the rest as messages to compact.
|
||||
- **Integrity guarantee**: preserves complete user-assistant turns and tool_use/tool_result pairs without splitting
|
||||
them.
|
||||
|
||||
---
|
||||
|
||||
#### 2. `compact_memory` — conversation compaction
|
||||
|
||||
[Compactor](reme/memory/file_based/components/compactor.py) uses a ReActAgent to compact conversation history into a *
|
||||
*structured context summary**.
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
M[messages] --> H[AsMsgHandler<br>format_msgs_to_str]
|
||||
H --> A[ReActAgent<br>reme_compactor]
|
||||
P[previous_summary] -->|Incremental update| A
|
||||
A --> S[Structured summary<br>Goal/Progress/Decisions...]
|
||||
```
|
||||
|
||||
**Summary structure** (context checkpoints):
|
||||
|
||||
| Field | Description |
|
||||
|-----------------------|-----------------------------------------------------------------------------------------|
|
||||
| `## Goal` | User goals |
|
||||
| `## Constraints` | Constraints and preferences |
|
||||
| `## Progress` | Task progress |
|
||||
| `## Key Decisions` | Key decisions |
|
||||
| `## Next Steps` | Next step plans |
|
||||
| `## Critical Context` | Critical data such as file paths, function names, error messages, etc. |
|
||||
|
||||
- **Incremental updates**: when `previous_summary` is provided, new conversations are merged into the existing summary.
|
||||
- **Thinking enhancement**: with `add_thinking_block=True` (default), a reasoning step is added before generating the
|
||||
summary to improve quality.
|
||||
|
||||
---
|
||||
|
||||
#### 3. `summary_memory` — persistent memory
|
||||
|
||||
[Summarizer](reme/memory/file_based/components/summarizer.py) uses a **ReAct + file tools** pattern so that the AI can
|
||||
decide what to write and where to write it.
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
M[messages] --> A[ReActAgent<br>reme_summarizer]
|
||||
A -->|read| R[Read memory/YYYY-MM-DD.md]
|
||||
R --> T{Reason: how to merge?}
|
||||
T -->|write| W[Overwrite]
|
||||
T -->|edit| E[Edit in place]
|
||||
W --> F[memory/YYYY-MM-DD.md]
|
||||
E --> F
|
||||
```
|
||||
|
||||
**File tools** ([FileIO](reme/memory/file_based/tools/file_io.py)):
|
||||
|
||||
| Tool | Function |
|
||||
|---------|-----------------------|
|
||||
| `read` | Read file content |
|
||||
| `write` | Overwrite file |
|
||||
| `edit` | Find-and-replace edit |
|
||||
|
||||
---
|
||||
|
||||
#### 4. `compact_tool_result` — tool result compaction
|
||||
|
||||
[ToolResultCompactor](reme/memory/file_based/components/tool_result_compactor.py) addresses the problem of long tool
|
||||
outputs bloating the context. It applies two different truncation strategies depending on whether a message falls within
|
||||
the `recent_n` window:
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
M[messages] --> B{Within recent_n?}
|
||||
B -->|Yes - recent| C[Low truncation recent_max_bytes=100KB<br>Save full content to tool_result/uuid.txt<br>Hint: 'Read from line N']
|
||||
B -->|No - old| D[High truncation old_max_bytes=3KB<br>Reference existing file<br>More aggressive truncation]
|
||||
C --> E[cleanup_expired_files<br>Delete expired files]
|
||||
D --> E
|
||||
```
|
||||
|
||||
| Parameter | Default | Description |
|
||||
|--------------------|-----------------------|-------------------------------------------------------------------------------------------------------------------------------|
|
||||
| `recent_n` | `1` | Minimum number of trailing consecutive tool-result messages treated as "recent" (use low truncation) |
|
||||
| `recent_max_bytes` | `100 * 1024` (100 KB) | Truncation threshold for recent messages; content beyond this is saved to `tool_result/` with a file path and start-line hint |
|
||||
| `old_max_bytes` | `3000` (3 KB) | Truncation threshold for older messages; truncation is more aggressive |
|
||||
| `retention_days` | `3` | Number of days to retain tool result files; expired files are auto-cleaned |
|
||||
|
||||
- **Auto cleanup**: expired files (older than `retention_days`) are deleted automatically during `start` / `close` /
|
||||
`compact_tool_result`.
|
||||
|
||||
---
|
||||
|
||||
#### 5. `memory_search` — memory retrieval
|
||||
|
||||
[MemorySearch](reme/memory/file_based/tools/memory_search.py) provides **vector + BM25 hybrid retrieval**.
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
Q[query] --> E[Embedding<br>Vectorization]
|
||||
E --> V[vector_search<br>Semantic similarity]
|
||||
Q --> B[BM25<br>Keyword matching]
|
||||
V -->|" weight: 0.7 "| M[Deduplicate + weighted merge]
|
||||
B -->|" weight: 0.3 "| M
|
||||
M --> F[min_score filter]
|
||||
F --> R[Top-N results]
|
||||
```
|
||||
|
||||
- **Fusion mechanism**: vector weight 0.7 + BM25 weight 0.3 — balancing semantic similarity and exact matches.
|
||||
|
||||
---
|
||||
|
||||
#### 6. `ReMeInMemoryMemory` — in-session memory
|
||||
|
||||
[ReMeInMemoryMemory](reme/memory/file_based/reme_in_memory_memory.py) extends AgentScope's `InMemoryMemory` to provide
|
||||
token-aware memory management and raw conversation persistence.
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
C[content] --> G[get_memory<br>exclude_mark=COMPRESSED]
|
||||
G --> F[Filter out compressed messages]
|
||||
F --> P{prepend_summary?}
|
||||
P -->|Yes| S[Prepend previous summary]
|
||||
S --> O[Output messages]
|
||||
P -->|No| O
|
||||
M[mark_messages_compressed] --> D[Persist to dialog/YYYY-MM-DD.jsonl]
|
||||
D --> R[Remove from memory]
|
||||
```
|
||||
|
||||
| Function | Description |
|
||||
|----------------------------------|----------------------------------------------------------|
|
||||
| `get_memory` | Filter messages by mark and auto-append summary |
|
||||
| `estimate_tokens` | Estimate token usage of the context |
|
||||
| `state_dict` / `load_state_dict` | Serialize/deserialize state (session persistence) |
|
||||
| `mark_messages_compressed` | Mark messages compressed and persist to dialog directory |
|
||||
| `clear_content` | Persist all messages before clearing memory |
|
||||
|
||||
**Raw conversation persistence**: When messages are compressed or cleared, they are automatically saved to
|
||||
`{dialog_path}/{date}.jsonl` with one JSON-formatted message per line.
|
||||
|
||||
---
|
||||
|
||||
#### 7. `pre_reasoning_hook` — pre-reasoning processing
|
||||
|
||||
This is a unified entry point that wires all the above components together and automatically manages context before each
|
||||
reasoning step.
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
M[messages] --> TC[compact_tool_result<br>Compact long tool outputs]
|
||||
TC --> CC[check_context<br>Compute remaining space]
|
||||
CC --> D{messages_to_compact<br>Non-empty?}
|
||||
D -->|No| K[Return original messages + summary]
|
||||
D -->|Yes| V{is_valid?}
|
||||
V -->|No| K
|
||||
V -->|Yes| CM[compact_memory<br>Sync summary generation]
|
||||
V -->|Yes| SM[add_async_summary_task<br>Async persistence]
|
||||
CM --> R[Return messages_to_keep + new summary]
|
||||
```
|
||||
|
||||
**Execution flow**:
|
||||
|
||||
1. `compact_tool_result` — compact long tool outputs for all messages except the most recent
|
||||
`tool_result_compact_keep_n`.
|
||||
2. `check_context` — check whether the context exceeds limits (remaining space = threshold minus tokens used by system
|
||||
prompt and compressed summary).
|
||||
3. `compact_memory` — generate compact summary (sync), appended into `compact_summary`.
|
||||
4. `summary_memory` — persist memory to `memory/*.md` (async in the background, non-blocking).
|
||||
|
||||
| Key parameter | Default | Description |
|
||||
|------------------------------|---------|-------------------------------------------------------------------------------------|
|
||||
| `tool_result_compact_keep_n` | `3` | Skip tool result compaction for the most recent N messages (preserve full content) |
|
||||
| `memory_compact_reserve` | `10000` | Token count to reserve for recent messages; messages beyond this trigger compaction |
|
||||
| `compact_ratio` | `0.7` | Compaction threshold ratio: `max_input_length × compact_ratio × 0.95` |
|
||||
|
||||
---
|
||||
|
||||
## 🗃️ Vector-based memory system
|
||||
|
||||
[ReMe Vector Based](reme/reme.py) is the core class for the vector-based memory system. It manages three types of
|
||||
memories:
|
||||
|
||||
| Memory type | Use case |
|
||||
|-----------------------|-------------------------------------------------------------------|
|
||||
| **Personal memory** | Records user preferences and habits |
|
||||
| **Procedural memory** | Records task execution experience and patterns of success/failure |
|
||||
| **Tool memory** | Records tool usage experience and parameter tuning |
|
||||
|
||||
### Core capabilities
|
||||
|
||||
| Method | Function | Description |
|
||||
|--------------------|--------------|-------------------------------------------------------------|
|
||||
| `summarize_memory` | 🧠 Summarize | Automatically extract and store memories from conversations |
|
||||
| `retrieve_memory` | 🔍 Retrieve | Retrieve related memories based on a query |
|
||||
| `add_memory` | ➕ Add | Manually add memories into the vector store |
|
||||
| `get_memory` | 📖 Get | Get a single memory by ID |
|
||||
| `update_memory` | ✏️ Update | Update existing memory content or metadata |
|
||||
| `delete_memory` | 🗑️ Delete | Delete a specific memory |
|
||||
| `list_memory` | 📋 List | List memories with filtering and sorting |
|
||||
|
||||
### Installation and environment variables
|
||||
|
||||
Installation and environment configuration are the same as [ReMeLight](#installation).
|
||||
API keys are configured via environment variables and can be stored in a `.env` file at the project root.
|
||||
|
||||
### Python usage
|
||||
|
||||
```python
|
||||
import asyncio
|
||||
|
||||
from reme import ReMe
|
||||
|
||||
|
||||
async def main():
|
||||
# Initialize ReMe
|
||||
reme = ReMe(
|
||||
working_dir=".reme",
|
||||
default_llm_config={
|
||||
"backend": "openai",
|
||||
"model_name": "qwen3.5-plus",
|
||||
},
|
||||
default_embedding_model_config={
|
||||
"backend": "openai",
|
||||
"model_name": "text-embedding-v4",
|
||||
"dimensions": 1024,
|
||||
},
|
||||
default_vector_store_config={
|
||||
"backend": "local", # Supports local/chroma/qdrant/elasticsearch/obvec/zvec/hologres
|
||||
},
|
||||
)
|
||||
await reme.start()
|
||||
|
||||
messages = [
|
||||
{"role": "user", "content": "Help me write a Python script", "time_created": "2026-02-28 10:00:00"},
|
||||
{"role": "assistant", "content": "Sure, I'll help you with that.", "time_created": "2026-02-28 10:00:05"},
|
||||
]
|
||||
|
||||
# 1. Summarize memories from conversation (automatically extract user preferences, task experience, etc.)
|
||||
result = await reme.summarize_memory(
|
||||
messages=messages,
|
||||
user_name="alice", # Personal memory
|
||||
# task_name="code_writing", # Procedural memory
|
||||
)
|
||||
print(f"Summary result: {result}")
|
||||
|
||||
# 2. Retrieve related memories
|
||||
memories = await reme.retrieve_memory(
|
||||
query="Python programming",
|
||||
user_name="alice",
|
||||
# task_name="code_writing",
|
||||
)
|
||||
print(f"Retrieved memories: {memories}")
|
||||
|
||||
# 3. Manually add a memory
|
||||
memory_node = await reme.add_memory(
|
||||
memory_content="The user prefers concise code style.",
|
||||
user_name="alice",
|
||||
)
|
||||
print(f"Added memory: {memory_node}")
|
||||
memory_id = memory_node.memory_id
|
||||
|
||||
# 4. Get a single memory by ID
|
||||
fetched_memory = await reme.get_memory(memory_id=memory_id)
|
||||
print(f"Fetched memory: {fetched_memory}")
|
||||
|
||||
# 5. Update memory content
|
||||
updated_memory = await reme.update_memory(
|
||||
memory_id=memory_id,
|
||||
user_name="alice",
|
||||
memory_content="The user prefers concise code with comments.",
|
||||
)
|
||||
print(f"Updated memory: {updated_memory}")
|
||||
|
||||
# 6. List all memories for the user (supports filtering and sorting)
|
||||
all_memories = await reme.list_memory(
|
||||
user_name="alice",
|
||||
limit=10,
|
||||
sort_key="time_created",
|
||||
reverse=True,
|
||||
)
|
||||
print(f"User memory list: {all_memories}")
|
||||
|
||||
# 7. Delete a specific memory
|
||||
await reme.delete_memory(memory_id=memory_id)
|
||||
print(f"Deleted memory: {memory_id}")
|
||||
|
||||
# 8. Delete all memories (use with care)
|
||||
# await reme.delete_all()
|
||||
|
||||
await reme.close()
|
||||
|
||||
|
||||
if __name__ == "__main__":
|
||||
asyncio.run(main())
|
||||
```
|
||||
|
||||
### Technical architecture
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
User[User / Agent] --> ReMe[Vector Based ReMe]
|
||||
ReMe --> Summarize[Summarize memories]
|
||||
ReMe --> Retrieve[Retrieve memories]
|
||||
ReMe --> CRUD[CRUD operations]
|
||||
Summarize --> PersonalSum[PersonalSummarizer]
|
||||
Summarize --> ProceduralSum[ProceduralSummarizer]
|
||||
Summarize --> ToolSum[ToolSummarizer]
|
||||
Retrieve --> PersonalRet[PersonalRetriever]
|
||||
Retrieve --> ProceduralRet[ProceduralRetriever]
|
||||
Retrieve --> ToolRet[ToolRetriever]
|
||||
PersonalSum --> VectorStore[Vector database]
|
||||
ProceduralSum --> VectorStore
|
||||
ToolSum --> VectorStore
|
||||
PersonalRet --> VectorStore
|
||||
ProceduralRet --> VectorStore
|
||||
ToolRet --> VectorStore
|
||||
```
|
||||
|
||||
### Experimental results
|
||||
|
||||
Evaluations are conducted on two benchmarks: **LoCoMo** and **HaluMem**. Experimental settings:
|
||||
|
||||
1. **ReMe backbone**: as specified in each table.
|
||||
2. **Evaluation protocol**: LLM-as-a-Judge following MemOS — each answer is scored by GPT-4o-mini.
|
||||
|
||||
Baseline results are reproduced from their respective papers under aligned settings where possible.
|
||||
|
||||
### LoCoMo
|
||||
|
||||
| Method | Single Hop | Multi Hop | Temporal | Open Domain | Overall |
|
||||
|----------|------------|-----------|-----------|-------------|-----------|
|
||||
| MemoryOS | 62.43 | 56.50 | 37.18 | 40.28 | 54.70 |
|
||||
| Mem0 | 66.71 | 58.16 | 55.45 | 40.62 | 61.00 |
|
||||
| MemU | 72.77 | 62.41 | 33.96 | 46.88 | 61.15 |
|
||||
| MemOS | 81.45 | 69.15 | 72.27 | 60.42 | 75.87 |
|
||||
| HiMem | 89.22 | 70.92 | 74.77 | 54.86 | 80.71 |
|
||||
| Zep | 88.11 | 71.99 | 74.45 | 66.67 | 81.06 |
|
||||
| TiMem | 81.43 | 62.20 | 77.63 | 52.08 | 75.30 |
|
||||
| TSM | 84.30 | 66.67 | 71.03 | 58.33 | 76.69 |
|
||||
| MemR3 | 89.44 | 71.39 | 76.22 | 61.11 | 81.55 |
|
||||
| **ReMe** | **89.89** | **82.98** | **83.80** | **71.88** | **86.23** |
|
||||
|
||||
### HaluMem
|
||||
|
||||
| Method | Memory Integrity | Memory Accuracy | QA Accuracy |
|
||||
|-------------|------------------|-----------------|-------------|
|
||||
| MemoBase | 14.55 | 92.24 | 35.53 |
|
||||
| Supermemory | 41.53 | 90.32 | 54.07 |
|
||||
| Mem0 | 42.91 | 86.26 | 53.02 |
|
||||
| ProMem | **73.80** | 89.47 | 62.26 |
|
||||
| **ReMe** | 67.72 | **94.06** | **88.78** |
|
||||
|
||||
---
|
||||
|
||||
## 🧪 Procedural memory paper
|
||||
|
||||
> Our procedural (task) memory paper is available on [arXiv](https://arxiv.org/abs/2512.10696).
|
||||
|
||||
### 🌍 [Appworld benchmark](benchmark/appworld/quickstart.md)
|
||||
|
||||
We evaluate ReMe on the Appworld environment using Qwen3-8B (non-thinking mode):
|
||||
|
||||
| Method | Avg@4 | Pass@4 |
|
||||
|----------|---------------------|---------------------|
|
||||
| w/o ReMe | 0.1497 | 0.3285 |
|
||||
| w/ ReMe | 0.1706 **(+2.09%)** | 0.3631 **(+3.46%)** |
|
||||
|
||||
Pass@K measures the probability that at least one of K generated candidates successfully completes the task (score=1).
|
||||
The current experiments use an internal AppWorld environment, which may differ slightly from the public version.
|
||||
|
||||
For more details on how to reproduce the experiments, see [quickstart.md](benchmark/appworld/quickstart.md).
|
||||
|
||||
### 🔧 [BFCL-V3 benchmark](benchmark/bfcl/quickstart.md)
|
||||
|
||||
We evaluate ReMe on the BFCL-V3 multi-turn-base task (random split 50 train / 150 val) using Qwen3-8B (thinking mode):
|
||||
|
||||
| Method | Avg@4 | Pass@4 |
|
||||
|----------|---------------------|---------------------|
|
||||
| w/o ReMe | 0.4033 | 0.5955 |
|
||||
| w/ ReMe | 0.4450 **(+4.17%)** | 0.6577 **(+6.22%)** |
|
||||
|
||||
For more details on how to reproduce the experiments, see [quickstart.md](benchmark/bfcl/quickstart.md).
|
||||
|
||||
## ⭐ Community & support
|
||||
|
||||
- **Star & Watch**: Starring helps more agent developers discover ReMe; Watching keeps you up to date with new releases
|
||||
and features.
|
||||
- **Share your results**: Share how ReMe empowers your agents in Issues or Discussions — we are happy to showcase great
|
||||
community use cases.
|
||||
- **Need a new feature?** Open a feature request; we’ll evolve ReMe together with the community.
|
||||
- **Code contributions**: All forms of contributions are welcome. Please see
|
||||
the [contribution guide](docs/contribution.md).
|
||||
- **Acknowledgements**: We thank excellent open-source projects such as OpenClaw, Mem0, MemU, and QwenPaw for their
|
||||
inspiration and support.
|
||||
|
||||
### Contributors
|
||||
|
||||
Thanks to all who have contributed to ReMe:
|
||||
|
||||
<a href="https://github.com/agentscope-ai/ReMe/graphs/contributors">
|
||||
<img src="https://contrib.rocks/image?repo=agentscope-ai/ReMe" alt="Contributors" />
|
||||
</a>
|
||||
|
||||
---
|
||||
|
||||
## 📄 Citation
|
||||
|
||||
```bibtex
|
||||
@software{AgentscopeReMe2025,
|
||||
title = {AgentscopeReMe: Memory Management Kit for Agents},
|
||||
author = {ReMe Team},
|
||||
url = {https://reme.agentscope.io},
|
||||
year = {2025}
|
||||
}
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## ⚖️ License
|
||||
|
||||
This project is open-sourced under the Apache License 2.0. See [LICENSE](./LICENSE) for details.
|
||||
|
||||
---
|
||||
|
||||
## 🤔 Why ReMe?
|
||||
|
||||
ReMe stands for **Remember Me** and **Refine Me**, symbolizing our goal to help AI agents "remember" users and "refine"
|
||||
themselves through interactions. We hope ReMe is not just a cold memory module, but a partner that truly helps agents
|
||||
understand users, accumulate experience, and continuously evolve.
|
||||
|
||||
---
|
||||
|
||||
## 📈 Star history
|
||||
|
||||
[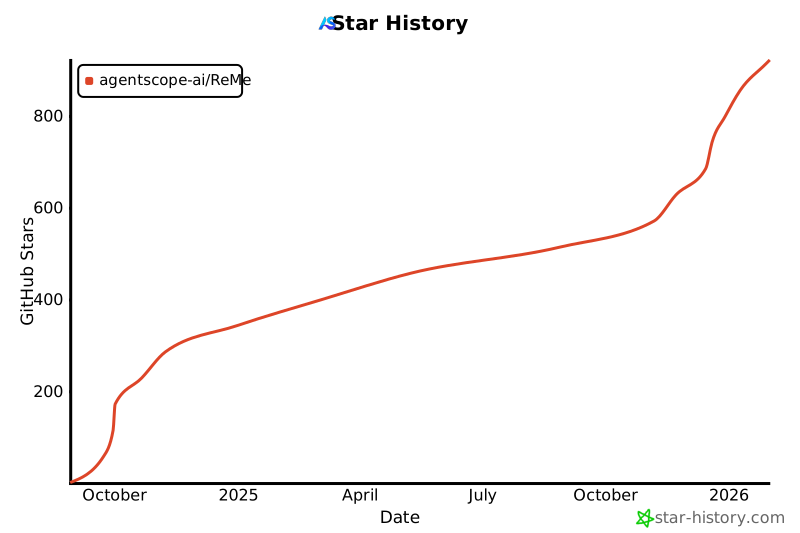](https://www.star-history.com/#agentscope-ai/ReMe&Date)
|
||||
|
||||
|
|
|
|||
|
|
@ -1,943 +0,0 @@
|
|||
# auto_dream 逻辑解读与 Step 拆分方案
|
||||
|
||||
## 1. 配置入口
|
||||
|
||||
`/Users/yuli/workspace/ReMe/reme/config/default.yaml` 里和 auto dream 相关的是四个 job:
|
||||
|
||||
| job | 用途 | 当前 steps |
|
||||
|---|---|---|
|
||||
| `dream` | 对单个文件做完整 dream,并顺手写一次 daily topics | `dream_step` -> `daily_topics_step` |
|
||||
| `dream_extract` | auto_dream 内部使用的单文件 dream,只抽取和整合 digest,不写 daily topics | `dream_step` |
|
||||
| `auto_dream` | 扫描某一天的 daily index 和 session notes,只处理新增/修改文件,最后聚合写当天兴趣主题 | `auto_dream_step` |
|
||||
| `daily_topics` | 从 dream 产生的 topic candidates 中选最终兴趣主题,写 `daily/<date>/interests.md` | `daily_topics_step` |
|
||||
|
||||
关键点:
|
||||
|
||||
- `dream` 和 `auto_dream` 不是同一条链路。
|
||||
- `dream` 是单文件命令,执行 `dream_step` 后立刻执行 `daily_topics_step`。
|
||||
- `auto_dream` 默认 `dispatch_job: dream_extract`,所以它对每个文件只跑 `dream_step`,把所有文件产生的 `topic_candidates` 收集起来,最后只调用一次 `daily_topics`。
|
||||
- `auto_dream` 默认写 3 个 topic,回看 7 天去重,输出 session id 是 `interests`。
|
||||
|
||||
配置片段的实际语义:
|
||||
|
||||
```yaml
|
||||
auto_dream:
|
||||
steps:
|
||||
- backend: auto_dream_step
|
||||
dispatch_job: dream_extract
|
||||
emit_topics: true
|
||||
topic_dispatch_job: daily_topics
|
||||
topic_count: 3
|
||||
topic_diversity_days: 7
|
||||
topic_session_id: interests
|
||||
```
|
||||
|
||||
也就是说,`auto_dream` 本身是一个调度器和增量扫描器,真正的 LLM dream 逻辑在 `DreamStep`,topic 写入在 `DailyTopicsStep`。
|
||||
|
||||
## 2. auto_dream_step 执行链路
|
||||
|
||||
实现位置:
|
||||
|
||||
- `reme/steps/evolve/auto_dream.py`
|
||||
- `reme/steps/evolve/dream.py`
|
||||
- `reme/steps/evolve/daily_topics.py`
|
||||
- `reme/steps/file_io/_daily_index.py`
|
||||
|
||||
### 2.1 读取输入和默认日期
|
||||
|
||||
`AutoDreamStep.execute()` 从 runtime context 读取:
|
||||
|
||||
| 参数 | 语义 |
|
||||
|---|---|
|
||||
| `date` | 要扫描的日期,空字符串时用配置 timezone 下的今天 |
|
||||
| `hint` | 透传给每个单文件 dream 的提示 |
|
||||
|
||||
日期默认逻辑:
|
||||
|
||||
```text
|
||||
date_input 非空 -> 使用 date_input
|
||||
date_input 为空 -> now(app_config.timezone).strftime("%Y-%m-%d")
|
||||
```
|
||||
|
||||
`daily_dir` 不来自用户参数,而是来自 app config,默认是 `daily`。
|
||||
|
||||
### 2.2 先刷新 day-index
|
||||
|
||||
正式扫描前,auto_dream 会先调用:
|
||||
|
||||
```python
|
||||
await refresh_day_index(self.file_store, today, daily_dir)
|
||||
```
|
||||
|
||||
它会重建:
|
||||
|
||||
```text
|
||||
daily/<date>.md
|
||||
```
|
||||
|
||||
这个 day-index 文件包含 `daily/<date>/` 下每个 session note 的链接和 frontmatter 摘要。这样 auto_dream 后续处理的第一个文件就是当天总览。
|
||||
|
||||
隐含结果:
|
||||
|
||||
- 如果 session notes 有新增/删除/frontmatter 变化,day-index 的内容可能变化。
|
||||
- day-index 被放在扫描列表第一位,所以当天总览先于具体 session note 被 dream。
|
||||
|
||||
### 2.3 扫描当天文件范围
|
||||
|
||||
扫描范围由 `_scan_today_files(vault, today, daily_dir)` 决定:
|
||||
|
||||
```text
|
||||
1. daily/<date>.md
|
||||
2. daily/<date>/**/*.md
|
||||
```
|
||||
|
||||
处理顺序:
|
||||
|
||||
```text
|
||||
daily/<date>.md first
|
||||
daily/<date>/**/*.md sorted by path
|
||||
```
|
||||
|
||||
但 auto_dream 会排除:
|
||||
|
||||
```text
|
||||
daily/<date>/interests.md
|
||||
```
|
||||
|
||||
也就是 `topic_session_id` 对应的 daily topics 文件。原因是 `interests.md` 是 auto_dream 自己产出的兴趣主题,不能再作为 dream 输入,否则容易自我循环。
|
||||
|
||||
### 2.4 用 file_catalog 做增量判断
|
||||
|
||||
auto_dream 构造两张表:
|
||||
|
||||
| 名称 | 来源 | 内容 |
|
||||
|---|---|---|
|
||||
| `existing` | 当前磁盘 | `{vault_relative_path: st_mtime}` |
|
||||
| `indexed` | `file_catalog.get_nodes()` | `{vault_relative_path: st_mtime}` |
|
||||
|
||||
`indexed` 只保留当天范围:
|
||||
|
||||
```text
|
||||
daily/<date>.md
|
||||
daily/<date>/*
|
||||
```
|
||||
|
||||
并且同样排除:
|
||||
|
||||
```text
|
||||
daily/<date>/interests.md
|
||||
```
|
||||
|
||||
然后做 diff:
|
||||
|
||||
| 条件 | 分类 | 行为 |
|
||||
|---|---|---|
|
||||
| `rel in existing`,但 catalog 没有 | added | 需要 dream |
|
||||
| `rel in existing`,但 mtime 不同 | modified | 需要 dream |
|
||||
| `rel in existing`,且 mtime 相同 | unchanged | 跳过 |
|
||||
| catalog 有,但磁盘没有 | deleted | 从 catalog 删除 |
|
||||
|
||||
注意这里的 `file_catalog` 更像是 auto_dream 的“已处理 mtime 水位线”,不是语义索引本身。默认配置没有给 `auto_dream_step` 显式传 `file_catalog`,所以按 `BaseStep.Ref` 规则解析到 `file_catalog.default`。
|
||||
|
||||
### 2.5 先删除 catalog 中的缺失文件
|
||||
|
||||
如果某些当天文件已经不存在:
|
||||
|
||||
```python
|
||||
await self.file_catalog.delete(to_delete)
|
||||
```
|
||||
|
||||
这一步不需要 LLM,也不会阻塞后续 dream。删除失败只记录日志,当前实现不会把它计入 `result.files_failed`。
|
||||
|
||||
### 2.6 对新增/修改文件逐个 dispatch dream_extract
|
||||
|
||||
对每个 `to_dream` 文件,auto_dream 调:
|
||||
|
||||
```python
|
||||
resp = await self.run_job("dream_extract", path=rel_path, hint=hint)
|
||||
```
|
||||
|
||||
`dream_extract` 只有一个 step:
|
||||
|
||||
```yaml
|
||||
steps:
|
||||
- backend: dream_step
|
||||
```
|
||||
|
||||
`AutoDreamStep._dispatch_dream()` 会把 `resp.metadata` 重新校验成 `DreamResult`。如果 job 抛异常、metadata 不是 `DreamResult`、或 response `success=False`,都会转成带 `error` 的 `DreamResult`。
|
||||
|
||||
### 2.7 单文件 DreamStep 内部逻辑
|
||||
|
||||
`DreamStep.dream_one(path, hint)` 是真正的 per-file create_or_update。
|
||||
|
||||
它的主流程:
|
||||
|
||||
```text
|
||||
1. path 为空 -> skipped
|
||||
2. 没有 LLM -> error
|
||||
3. _pack_material() 读取 vault-relative 文件内容
|
||||
4. Phase 1: _extract()
|
||||
5. 如果 Phase 1 没有 units -> skipped,但保留 topic_candidates
|
||||
6. Phase 2: 对每个 unit 调 _integrate_unit()
|
||||
7. 返回 DreamResult
|
||||
```
|
||||
|
||||
#### Phase 1: extract
|
||||
|
||||
工具:
|
||||
|
||||
```python
|
||||
_EXTRACT_TOOLS = ("read",)
|
||||
```
|
||||
|
||||
输出 schema 是 `ExtractedUnits`:
|
||||
|
||||
```text
|
||||
units: list[MemoryUnit]
|
||||
topic_candidates: list[TopicCandidate]
|
||||
```
|
||||
|
||||
每个 memory unit 包含:
|
||||
|
||||
| 字段 | 语义 |
|
||||
|---|---|
|
||||
| `name` | agent 内部短名 |
|
||||
| `bucket` | `procedure` / `personal` / `wiki` 三选一 |
|
||||
| `summary` | 这个抽象是什么,证据在哪 |
|
||||
|
||||
每个 topic candidate 包含:
|
||||
|
||||
| 字段 | 语义 |
|
||||
|---|---|
|
||||
| `title` | 兴趣主题标题 |
|
||||
| `reason` | 为什么用户可能关心 |
|
||||
| `evidence` | 证据指针 |
|
||||
| `keywords` | 去重关键词 |
|
||||
|
||||
如果 LLM 输出了未知 bucket,当前代码会警告并改成 `wiki`。
|
||||
|
||||
#### Phase 2: integrate
|
||||
|
||||
每个 unit 单独发起一次 ReAct:
|
||||
|
||||
```text
|
||||
system prompt = integrate_system_prompt_<bucket>
|
||||
```
|
||||
|
||||
工具:
|
||||
|
||||
```python
|
||||
_INTEGRATE_TOOLS = (
|
||||
"node_search",
|
||||
"read",
|
||||
"frontmatter_read",
|
||||
"write",
|
||||
"edit",
|
||||
"frontmatter_update",
|
||||
)
|
||||
```
|
||||
|
||||
输出 schema 是 `IntegrateOutcome`:
|
||||
|
||||
| 字段 | 语义 |
|
||||
|---|---|
|
||||
| `action` | `CREATE` / `CORROBORATE` / `REFINE` / `CORRECT` |
|
||||
| `target_path` | 实际写入或更新的 digest path |
|
||||
| `note` | 简短说明 |
|
||||
|
||||
`DreamStep` 根据 action 统计:
|
||||
|
||||
```text
|
||||
CREATE -> nodes_created
|
||||
其他 action -> nodes_updated
|
||||
```
|
||||
|
||||
当前实现里,某个 unit 的 integrate 失败不会让整个 DreamResult 变成 error,只会在 summary 里记录 `FAILED`。这意味着文件级别仍会被 auto_dream 当作成功并写入 catalog mtime。
|
||||
|
||||
### 2.8 汇总 per-file 结果并更新 catalog
|
||||
|
||||
auto_dream 对每个文件的 `DreamResult` 做三件事:
|
||||
|
||||
| 情况 | 行为 |
|
||||
|---|---|
|
||||
| `dr.error` 非空 | `files_failed += 1`,不更新这个文件的 catalog mtime,下次会重试 |
|
||||
| `dr.skipped` 为 true | `files_skipped += 1`,仍然 upsert mtime,避免每次重复跑 Phase 1 |
|
||||
| 正常 dream | `files_dreamed += 1`,upsert mtime |
|
||||
|
||||
同时收集:
|
||||
|
||||
```python
|
||||
topic_candidates.extend(dr.topic_candidates or [])
|
||||
```
|
||||
|
||||
最后批量:
|
||||
|
||||
```python
|
||||
await self.file_catalog.upsert(upsert_nodes)
|
||||
```
|
||||
|
||||
### 2.9 聚合写 daily topics
|
||||
|
||||
如果:
|
||||
|
||||
```text
|
||||
emit_topics == true
|
||||
topic_candidates 非空
|
||||
```
|
||||
|
||||
auto_dream 会调用:
|
||||
|
||||
```python
|
||||
await self.run_job(
|
||||
"daily_topics",
|
||||
date=today,
|
||||
candidates=topic_candidates,
|
||||
topic_count=3,
|
||||
diversity_days=7,
|
||||
session_id="interests",
|
||||
)
|
||||
```
|
||||
|
||||
`DailyTopicsStep` 做:
|
||||
|
||||
```text
|
||||
1. 清洗 candidates
|
||||
2. 读取过去 diversity_days 天的 interests.md
|
||||
3. 有 LLM 时用 select prompt 选最终 topics
|
||||
4. 没有 LLM 时 fallback: 简单标题去重
|
||||
5. 写 daily/<date>/interests.md
|
||||
6. refresh_day_index()
|
||||
```
|
||||
|
||||
写出的文件形态:
|
||||
|
||||
```text
|
||||
daily/<date>/interests.md
|
||||
```
|
||||
|
||||
frontmatter 包含:
|
||||
|
||||
```yaml
|
||||
name: interests
|
||||
description: "<n> interest topic(s) inferred for <date>."
|
||||
date: <date>
|
||||
topic_count: 3
|
||||
diversity_days: 7
|
||||
```
|
||||
|
||||
body 是 `# Interested Topics` 加编号列表。
|
||||
|
||||
auto_dream 收到 daily_topics 成功响应后,还会把这些文件的最新 mtime 写入 catalog:
|
||||
|
||||
```text
|
||||
daily/<date>/interests.md
|
||||
daily/<date>.md
|
||||
```
|
||||
|
||||
这里有一个隐含行为:day-index 在 per-file dream 之后又因为 `interests.md` 被写入而刷新,auto_dream 会把刷新后的 `daily/<date>.md` mtime 标记为已处理。也就是说,仅由 interests 写入引发的 day-index 变化不会在下一轮再次触发 dream。
|
||||
|
||||
### 2.10 持久化与响应
|
||||
|
||||
如果:
|
||||
|
||||
```text
|
||||
persist == true
|
||||
并且有 upsert 或 delete
|
||||
```
|
||||
|
||||
则:
|
||||
|
||||
```python
|
||||
await self.file_catalog.dump()
|
||||
```
|
||||
|
||||
最终 response:
|
||||
|
||||
```text
|
||||
success = files_failed == 0 and not topics_error
|
||||
answer = AutoDreamResult.summary
|
||||
metadata = AutoDreamResult.model_dump()
|
||||
```
|
||||
|
||||
summary 格式大致是:
|
||||
|
||||
```text
|
||||
[AutoDreamStep] date=2026-06-18 scanned=... unchanged=... dreamed=... skipped=... failed=... deleted=...
|
||||
- daily/2026-06-18.md: OK (+1 created, ~2 updated)
|
||||
- daily/2026-06-18/session.md: SKIP
|
||||
- topics: OK (3 written to daily/2026-06-18/interests.md)
|
||||
```
|
||||
|
||||
## 3. 当前逻辑的边界和风险
|
||||
|
||||
### 3.1 AutoDreamStep 职责过重
|
||||
|
||||
`AutoDreamStep` 同时负责:
|
||||
|
||||
- 日期解析
|
||||
- day-index 刷新
|
||||
- 文件扫描
|
||||
- catalog diff
|
||||
- 删除 catalog
|
||||
- per-file job dispatch
|
||||
- DreamResult 校验
|
||||
- topic candidates 汇总
|
||||
- daily_topics job dispatch
|
||||
- topic 输出后的 catalog upsert
|
||||
- catalog dump
|
||||
- summary 渲染
|
||||
|
||||
这些职责可以拆成明确 step,提高可测试性和可替换性。
|
||||
|
||||
### 3.2 file_catalog 的语义不够显式
|
||||
|
||||
这里的 catalog 不是“今天有哪些文件”的普通目录索引,而是“哪些文件已经被 auto_dream 处理到某个 mtime”。建议在拆分后把它显式命名为 dream catalog / processed catalog,至少在 step 名和文档中说清楚。
|
||||
|
||||
### 3.3 integrate unit 失败不会触发文件重试
|
||||
|
||||
`DreamStep` 当前捕获单个 unit integrate 异常,写进 summary 后继续,但不设置 `DreamResult.error`。auto_dream 因此会把这个文件 mtime upsert,下次不会自动重试失败 unit。
|
||||
|
||||
这可能是有意的“尽量前进”,但如果要做严格一致性,应改成:
|
||||
|
||||
```text
|
||||
任一 unit integrate 失败 -> DreamResult.error 非空 -> auto_dream 不更新 mtime
|
||||
```
|
||||
|
||||
### 3.4 topic 写入导致的 day-index 变化被标记为已处理
|
||||
|
||||
auto_dream 写 `interests.md` 后刷新 day-index,并把 day-index 最新 mtime upsert 到 catalog。这样可以避免自生成内容触发循环,但也意味着 `daily/<date>.md` 中新增的 `interests.md` 链接不会被 dream。
|
||||
|
||||
这通常是合理的,因为 `interests.md` 本身被排除在 dream 输入之外。
|
||||
|
||||
### 3.5 删除 catalog 失败不影响 success
|
||||
|
||||
删除 catalog entry 失败只打日志,不会让 response failure。拆分后可以明确这个策略:
|
||||
|
||||
- catalog delete 是 best-effort,不影响 dream 主流程
|
||||
- 或者 catalog delete 失败应导致整个 job failure
|
||||
|
||||
## 4. 拆分目标
|
||||
|
||||
重新拆分时,不按“每个小动作一个 step”拆,而按执行边界拆:
|
||||
|
||||
```text
|
||||
非 LLM 准备/扫描/diff
|
||||
-> LLM: per-file dream
|
||||
-> LLM: daily topics
|
||||
-> 非 LLM response 汇总
|
||||
```
|
||||
|
||||
核心原则:
|
||||
|
||||
- 使用 LLM 的阶段单独成 step,便于限流、重试、观测和替换模型。
|
||||
- 不使用 LLM 的准备、扫描、diff 可以合并,避免 step 过碎。
|
||||
- catalog 只是 auto_dream 的内部进度水位线,不提升为独立阶段。
|
||||
- prompt 重新写,但可以复用旧 prompt 的核心内容和约束。
|
||||
- 不做旧接口/旧格式兼容;按新 4-step pipeline 重新定义最干净的输入输出。
|
||||
|
||||
## 5. 新方案:拆成 4 个 Step
|
||||
|
||||
新方案不再是“逐文件 extract + 逐文件 integrate”。核心变化是:
|
||||
|
||||
```text
|
||||
本轮 changed files
|
||||
-> 1 个 agent 一次性阅读所有 changed paths
|
||||
-> 输出全局去重/合并后的 unit list
|
||||
-> Python for 循环逐 unit integrate
|
||||
```
|
||||
|
||||
这样一个抽象可能来自多个文件,Phase 1 就能合并为同一个 unit,避免同一天多个 session note 反复提出同一概念。
|
||||
|
||||
目标代码位置:
|
||||
|
||||
```text
|
||||
reme/steps/evolve/dream/
|
||||
__init__.py
|
||||
models.py
|
||||
plan.py
|
||||
extract.py
|
||||
integrate.py
|
||||
topics.py
|
||||
finish.py
|
||||
prompts.yaml 或 dream.yaml
|
||||
```
|
||||
|
||||
重构完成后删除旧文件,不保留兼容 alias:
|
||||
|
||||
```text
|
||||
reme/steps/evolve/dream.py
|
||||
reme/steps/evolve/auto_dream.py
|
||||
reme/steps/evolve/daily_topics.py
|
||||
```
|
||||
|
||||
### 5.0 Step 输入输出总表
|
||||
|
||||
| Step | 是否 LLM | 核心能力 | 输入 | 输出 / 写入 context | 副作用 |
|
||||
|---|---:|---|---|---|---|
|
||||
| `dream_extract_step` | 是 | 根据 dream catalog 找出本轮新增/修改/删除文件,把所有 changed paths 交给一个 agent,一次性输出跨文件合并后的 `unit_list` 和 `topic_list` | `context.date`; `context.hint`; `app_config.daily_dir`; `app_config.timezone`; `file_store.vault_path`; `file_catalog.dream`; step 参数 `topic_session_id=interests` | `dream.date`; `dream.hint`; `dream.daily_dir`; `dream.vault`; `dream.existing`; `dream.indexed`; `dream.changed_paths`; `dream.deleted_paths`; `dream.units`; `dream.topics`; `dream.extract_summary`; `dream.result.files_scanned/files_changed/files_deleted`; `dream.errors` | 刷新 `daily/<date>.md`; 删除 catalog 中缺失文件 entry; 读取所有 changed files; 本 step 不写 digest |
|
||||
| `dream_integrate_step` | 是 | `for unit in units` 逐个执行原 Phase 2 integrate 逻辑,保持 node_search/read/write/edit/frontmatter_update 工具和 bucket prompt 不变 | `dream.units`; `dream.hint`; `dream.vault`; `app_config.digest_dir`; agent tools: `node_search/read/frontmatter_read/write/edit/frontmatter_update` | `dream.integrate_results`; `dream.nodes_created`; `dream.nodes_updated`; `dream.result.units_integrated/units_failed`; `dream.errors` | 写/更新 `digest/<bucket>/*.md`; 不更新 dream catalog |
|
||||
| `dream_topics_step` | 是 | 根据 `topic_list` 更新 `daily/<date>/interests.yaml`; 读取当天已有 topics 和最近 N 天 topics 做去重 | `dream.date`; `dream.daily_dir`; `dream.topics`; `file_store.vault_path`; step 参数 `topic_count`; `topic_diversity_days`; `topic_session_id=interests` | `dream.topics_path=daily/<date>/interests.yaml`; `dream.topics_written`; `dream.topics_merged`; `dream.topics_skipped_duplicates`; `dream.errors` | 新建或更新 `daily/<date>/interests.yaml`; 刷新 `daily/<date>.md` |
|
||||
| `dream_finish_step` | 否 | 统一收口:按 path checkpoint 成功处理的文件,持久化 catalog,渲染 summary 和 response metadata | `dream.changed_paths`; `dream.deleted_paths`; `dream.failed_paths`; `dream.integrate_results`; `dream.topics_path`; `dream.errors`; `dream.result`; `file_catalog.dream`; step 参数 `persist=true` | `context.response.success`; `context.response.answer`; `context.response.metadata` | upsert successful paths 的 mtime 到 `file_catalog.dream`; upsert `interests.yaml` 和 day-index mtime; `file_catalog.dump()` |
|
||||
|
||||
### Step 1: `dream_extract_step`
|
||||
|
||||
这是新的全局 Phase 1。它合并了当前 `auto_dream_step` 的扫描/diff 和当前 `DreamStep._extract()` 的抽取能力。
|
||||
|
||||
职责:
|
||||
|
||||
- 解析 `date` / `hint`。
|
||||
- 刷新 day-index: `daily/<date>.md`。
|
||||
- 扫描输入文件并统一交给 extract agent:
|
||||
- `daily/<date>.md`
|
||||
- `daily/<date>/<session_id>.md`
|
||||
- `daily/<date>/<resource_stem>.md`
|
||||
- 以及 `daily/<date>/**/*.md` 下其它当天 note
|
||||
- 排除自生成文件:
|
||||
- `daily/<date>/interests.yaml`
|
||||
- 读取 `file_catalog.dream`,按 mtime diff 出:
|
||||
- `changed_paths`
|
||||
- `unchanged_paths`
|
||||
- `deleted_paths`
|
||||
- 删除 catalog 中 `deleted_paths`。
|
||||
- 打包所有 `changed_paths` 的文件内容。
|
||||
- 调用一次 extract agent,让它看见所有 changed paths。
|
||||
- 输出跨文件合并后的 `unit_list` 和 `topic_list`。
|
||||
|
||||
新的 unit schema:
|
||||
|
||||
```python
|
||||
class DreamUnit(BaseModel):
|
||||
name: str
|
||||
bucket: Literal["procedure", "personal", "wiki"]
|
||||
summary: str
|
||||
paths: list[str]
|
||||
```
|
||||
|
||||
`paths` 是这个 unit 的证据来源列表。多个文件讲的是同一抽象时,Phase 1 必须合并成一个 unit:
|
||||
|
||||
```json
|
||||
{
|
||||
"name": "jwt-session-expiry-policy",
|
||||
"bucket": "procedure",
|
||||
"summary": "How the project decides session expiry from compliance and product constraints.",
|
||||
"paths": [
|
||||
"daily/2026-06-18/auth.md",
|
||||
"daily/2026-06-18/api-review.md"
|
||||
]
|
||||
}
|
||||
```
|
||||
|
||||
topic schema 可以沿用当前 `TopicCandidate`,但建议把来源改成 `paths`:
|
||||
|
||||
```python
|
||||
class DreamTopicCandidate(BaseModel):
|
||||
title: str
|
||||
reason: str
|
||||
evidence: str
|
||||
keywords: list[str] = []
|
||||
paths: list[str] = []
|
||||
```
|
||||
|
||||
输出到 context:
|
||||
|
||||
```python
|
||||
{
|
||||
"dream": {
|
||||
"date": "YYYY-MM-DD",
|
||||
"changed_paths": [
|
||||
{"path": "daily/YYYY-MM-DD/a.md", "mtime": 1710000000.0}
|
||||
],
|
||||
"deleted_paths": [],
|
||||
"units": [
|
||||
{
|
||||
"name": "jwt-session-expiry-policy",
|
||||
"bucket": "procedure",
|
||||
"summary": "...",
|
||||
"paths": ["daily/YYYY-MM-DD/a.md", "daily/YYYY-MM-DD/b.md"]
|
||||
}
|
||||
],
|
||||
"topics": [
|
||||
{
|
||||
"title": "...",
|
||||
"reason": "...",
|
||||
"evidence": "...",
|
||||
"keywords": ["..."],
|
||||
"paths": ["daily/YYYY-MM-DD/a.md"]
|
||||
}
|
||||
]
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
LLM 调用数量:
|
||||
|
||||
```text
|
||||
1 个 agent 任务
|
||||
```
|
||||
|
||||
注意:
|
||||
|
||||
- 这个 step 不再为每个文件分别调用 `dream_extract`。
|
||||
- 如果 `changed_paths` 为空,它不调用 LLM,直接输出空 `units/topics`。
|
||||
- 只有 `dream_finish_step` 才把 changed file mtime 标为已处理。这样 integrate/topics 失败时不会误跳过。
|
||||
|
||||
### Step 2: `dream_integrate_step`
|
||||
|
||||
这是新的全局 Phase 2。它对 Step 1 输出的 `units` 做 Python for 循环,每个 unit 的 integrate 逻辑保持当前 `DreamStep._integrate_unit()` 不变。
|
||||
|
||||
职责:
|
||||
|
||||
- 遍历 `dream.units`。
|
||||
- 每个 unit 根据 `unit.bucket` 选择:
|
||||
- `integrate_system_prompt_procedure`
|
||||
- `integrate_system_prompt_personal`
|
||||
- `integrate_system_prompt_wiki`
|
||||
- material 不再是单文件 blob,而是这个 unit 对应 `paths` 的证据包。
|
||||
- 调用当前相同工具:
|
||||
- `node_search`
|
||||
- `read`
|
||||
- `frontmatter_read`
|
||||
- `write`
|
||||
- `edit`
|
||||
- `frontmatter_update`
|
||||
- 输出 `IntegrateOutcome`。
|
||||
|
||||
`integrate_user_message` 需要从单 `material_blob` 改成多路径 evidence blob:
|
||||
|
||||
```text
|
||||
unit_name: ...
|
||||
unit_bucket: ...
|
||||
unit_summary: ...
|
||||
source_paths:
|
||||
- daily/...
|
||||
- daily/...
|
||||
|
||||
# Evidence materials
|
||||
### daily/.../a.md
|
||||
...
|
||||
|
||||
### daily/.../b.md
|
||||
...
|
||||
```
|
||||
|
||||
输出:
|
||||
|
||||
```python
|
||||
{
|
||||
"dream": {
|
||||
"integrate_results": [
|
||||
{
|
||||
"unit_name": "jwt-session-expiry-policy",
|
||||
"bucket": "procedure",
|
||||
"action": "CREATE",
|
||||
"target_path": "digest/procedure/jwt-session-expiry-policy.md",
|
||||
"source_paths": ["daily/YYYY-MM-DD/a.md", "daily/YYYY-MM-DD/b.md"],
|
||||
"note": "..."
|
||||
}
|
||||
],
|
||||
"nodes_created": ["digest/procedure/jwt-session-expiry-policy.md"],
|
||||
"nodes_updated": []
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
LLM 调用数量:
|
||||
|
||||
```text
|
||||
N 个 agent 任务
|
||||
N = len(dream.units)
|
||||
```
|
||||
|
||||
失败策略建议:
|
||||
|
||||
- 任一 unit integrate 失败,记录到 `dream.errors`。
|
||||
- 因为每个 unit 都有明确的 `paths`,失败 unit 对应的 paths 进入 `dream.failed_paths`。
|
||||
- `dream_finish_step` 不 checkpoint `failed_paths`。
|
||||
- 不在任何失败 unit `paths` 里的 changed paths 可以 checkpoint。
|
||||
- 如果同一个 path 同时出现在成功 unit 和失败 unit 中,以失败为准,该 path 不 checkpoint。
|
||||
|
||||
### Step 3: `dream_topics_step`
|
||||
|
||||
这个 step 取代当前 `daily_topics_step`。目标文件固定为:
|
||||
|
||||
```text
|
||||
daily/<date>/interests.yaml
|
||||
```
|
||||
|
||||
职责:
|
||||
|
||||
- 读取 `dream.topics`。
|
||||
- 如果 `daily/<date>/interests.yaml` 已存在,读取旧 topics。
|
||||
- 读取最近 `topic_diversity_days` 天的 `daily/<previous-date>/interests.yaml` 作为历史去重上下文。
|
||||
- 合并当天旧 topics + 新 topics。
|
||||
- 去重:
|
||||
- 标题 normalize 后相同视为重复。
|
||||
- keywords 高重叠视为可能重复。
|
||||
- evidence/paths 完全相同视为重复。
|
||||
- 与最近 N 天历史 topics 重复时跳过。
|
||||
- 可选使用 LLM 对候选 topic 做最终选择和改写。
|
||||
- 写回 YAML。
|
||||
- 刷新 day-index。
|
||||
|
||||
建议 YAML 格式:
|
||||
|
||||
```yaml
|
||||
date: "2026-06-18"
|
||||
updated_at: "2026-06-18T22:00:00+08:00"
|
||||
topic_count: 3
|
||||
diversity_days: 7
|
||||
topics:
|
||||
- title: "JWT session expiry policy"
|
||||
reason: "The user repeatedly worked through compliance-driven auth expiry tradeoffs."
|
||||
evidence: "Mentioned in auth review and API notes."
|
||||
keywords: ["auth", "jwt", "session", "compliance"]
|
||||
paths:
|
||||
- "daily/2026-06-18/auth.md"
|
||||
- "daily/2026-06-18/api-review.md"
|
||||
```
|
||||
|
||||
输入:
|
||||
|
||||
```text
|
||||
dream.date
|
||||
dream.daily_dir
|
||||
dream.topics
|
||||
topic_count
|
||||
topic_diversity_days
|
||||
topic_session_id
|
||||
```
|
||||
|
||||
输出:
|
||||
|
||||
```python
|
||||
{
|
||||
"dream": {
|
||||
"topics_path": "daily/YYYY-MM-DD/interests.yaml",
|
||||
"topics_written": 3,
|
||||
"topics_merged": 5,
|
||||
"topics_skipped_duplicates": 2
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
LLM 调用数量:
|
||||
|
||||
```text
|
||||
0 或 1 个 agent 任务
|
||||
```
|
||||
|
||||
建议:
|
||||
|
||||
- 如果只是 append/去重,不必 LLM。
|
||||
- 如果需要从很多 candidates 中挑 `topic_count` 个,才调用 LLM。
|
||||
- 不读取也不写 `interests.md`;全新格式只认 `interests.yaml`。
|
||||
|
||||
### Step 4: `dream_finish_step`
|
||||
|
||||
这是非 LLM 收尾 step。
|
||||
|
||||
职责:
|
||||
|
||||
- 根据前面步骤结果决定 success。
|
||||
- 计算 `failed_paths`:
|
||||
- 每个失败 unit 的 `unit.paths` 都进入 failed set。
|
||||
- 如果某个 path 同时属于成功 unit 和失败 unit,以失败为准。
|
||||
- 计算 `checkpoint_paths`:
|
||||
- `changed_paths - failed_paths`
|
||||
- extract 成功但没有任何 unit/topics 的 changed paths 也可以 checkpoint,避免重复空跑。
|
||||
- 把 `checkpoint_paths` 的当前 mtime upsert 到 `file_catalog.dream`。
|
||||
- 把 `daily/<date>/interests.yaml` 的 mtime upsert 到 `file_catalog.dream`。
|
||||
- 把刷新后的 `daily/<date>.md` 的 mtime upsert 到 `file_catalog.dream`。
|
||||
- `deleted_paths` 的 catalog 删除在 extract step 已完成,finish 只负责 dump。
|
||||
- `file_catalog.dump()`。
|
||||
- 渲染 summary。
|
||||
- 写 `context.response.metadata`。
|
||||
|
||||
输出 metadata 建议:
|
||||
|
||||
```python
|
||||
{
|
||||
"date": "YYYY-MM-DD",
|
||||
"files_scanned": 10,
|
||||
"files_changed": 3,
|
||||
"files_deleted": 1,
|
||||
"paths_checkpointed": ["daily/2026-06-18/a.md"],
|
||||
"paths_failed": ["daily/2026-06-18/b.md"],
|
||||
"units_extracted": 4,
|
||||
"units_integrated": 4,
|
||||
"units_failed": 0,
|
||||
"topics_written": 3,
|
||||
"nodes_created": [...],
|
||||
"nodes_updated": [...],
|
||||
"errors": []
|
||||
}
|
||||
```
|
||||
|
||||
## 6. 拆分后的 YAML 形态
|
||||
|
||||
建议把 `auto_dream` 改成新的 dream pipeline:
|
||||
|
||||
```yaml
|
||||
auto_dream:
|
||||
backend: base
|
||||
description: "Auto-dream: scan daily changes, extract cross-file units, integrate digest nodes, update daily interests."
|
||||
parameters:
|
||||
type: object
|
||||
properties:
|
||||
date:
|
||||
type: string
|
||||
description: "YYYY-MM-DD to scan; defaults to today in the dreamer's timezone"
|
||||
default: ""
|
||||
hint:
|
||||
type: string
|
||||
description: "caller guidance passed through to the dreamer LLM"
|
||||
default: ""
|
||||
steps:
|
||||
- backend: dream_extract_step
|
||||
file_catalog: dream
|
||||
topic_session_id: interests
|
||||
- backend: dream_integrate_step
|
||||
- backend: dream_topics_step
|
||||
topic_count: 3
|
||||
topic_diversity_days: 7
|
||||
topic_session_id: interests
|
||||
- backend: dream_finish_step
|
||||
file_catalog: dream
|
||||
persist: true
|
||||
```
|
||||
|
||||
旧 job 删除,不做兼容 wrapper:
|
||||
|
||||
```yaml
|
||||
dream:
|
||||
# 删除
|
||||
|
||||
dream_extract:
|
||||
# 删除
|
||||
|
||||
daily_topics:
|
||||
# 删除
|
||||
```
|
||||
|
||||
## 7. 数据结构建议
|
||||
|
||||
建议所有跨 step 状态都放在 `context["dream"]`。
|
||||
|
||||
核心模型:
|
||||
|
||||
```python
|
||||
class DreamUnit(BaseModel):
|
||||
name: str
|
||||
bucket: Literal["procedure", "personal", "wiki"]
|
||||
summary: str
|
||||
paths: list[str] = Field(default_factory=list)
|
||||
|
||||
|
||||
class DreamTopic(BaseModel):
|
||||
title: str
|
||||
reason: str
|
||||
evidence: str = ""
|
||||
keywords: list[str] = Field(default_factory=list)
|
||||
paths: list[str] = Field(default_factory=list)
|
||||
|
||||
|
||||
class DreamState(BaseModel):
|
||||
date: str = ""
|
||||
hint: str = ""
|
||||
daily_dir: str = "daily"
|
||||
vault: str = ""
|
||||
changed_paths: list[dict] = Field(default_factory=list)
|
||||
unchanged_paths: list[str] = Field(default_factory=list)
|
||||
deleted_paths: list[str] = Field(default_factory=list)
|
||||
failed_paths: list[str] = Field(default_factory=list)
|
||||
checkpoint_paths: list[str] = Field(default_factory=list)
|
||||
units: list[DreamUnit] = Field(default_factory=list)
|
||||
topics: list[DreamTopic] = Field(default_factory=list)
|
||||
integrate_results: list[dict] = Field(default_factory=list)
|
||||
nodes_created: list[str] = Field(default_factory=list)
|
||||
nodes_updated: list[str] = Field(default_factory=list)
|
||||
topics_path: str = ""
|
||||
topics_written: int = 0
|
||||
errors: list[str] = Field(default_factory=list)
|
||||
result: dict = Field(default_factory=dict)
|
||||
```
|
||||
|
||||
## 8. 实现任务
|
||||
|
||||
这是一次 breaking rewrite,不存在旧接口/旧格式迁移任务。剩余工作就是按新设计实现 4 个 step。
|
||||
|
||||
必须实现:
|
||||
|
||||
1. 在 `reme/steps/evolve/dream/` 下新增 `models.py`、helper 和 4 个 step 文件。
|
||||
2. 重写 prompts:
|
||||
- `extract_system_prompt`
|
||||
- `extract_user_message`
|
||||
- `integrate_system_prompt_procedure`
|
||||
- `integrate_system_prompt_personal`
|
||||
- `integrate_system_prompt_wiki`
|
||||
- `integrate_user_message`
|
||||
- 可参考旧 prompt 的内容,但不保持旧 prompt 接口。
|
||||
3. 实现 `dream_extract_step`:
|
||||
- 扫描 `daily/<date>.md` 与 `daily/<date>/**/*.md`。
|
||||
- 排除 `daily/<date>/interests.yaml`。
|
||||
- 根据 `file_catalog.dream` 计算 changed/unchanged/deleted。
|
||||
- 一个 agent 统一读取所有 changed paths,输出全局 units/topics。
|
||||
- 清洗 units: unknown bucket fallback 到 `wiki`; paths 去重; paths 必须来自 changed paths。
|
||||
4. 实现 `dream_integrate_step`:
|
||||
- 按 `unit.paths` 打包 evidence。
|
||||
- for 循环逐 unit integrate。
|
||||
- 保留工具集合和 action 语义。
|
||||
- unit 失败时记录 `failed_paths += unit.paths`。
|
||||
5. 实现 `dream_topics_step`:
|
||||
- 只读写 `daily/<date>/interests.yaml`。
|
||||
- 读取当天已有 YAML topics。
|
||||
- 读取最近 `topic_diversity_days` 天的 `interests.yaml` 做历史去重。
|
||||
- 写回去重后的 YAML。
|
||||
- 刷新 day-index。
|
||||
6. 实现 `dream_finish_step`:
|
||||
- `checkpoint_paths = changed_paths - failed_paths`。
|
||||
- checkpoint 成功 paths 的 mtime。
|
||||
- checkpoint `interests.yaml` 和 `daily/<date>.md`。
|
||||
- dump `file_catalog.dream`。
|
||||
- 输出全新 response metadata。
|
||||
7. 更新 `default.yaml`:
|
||||
- `auto_dream` 改为 4-step pipeline。
|
||||
- 删除 `dream`、`dream_extract`、`daily_topics` job。
|
||||
- 保留 `file_catalog.dream`。
|
||||
8. 删除旧代码:
|
||||
- `reme/steps/evolve/auto_dream.py`
|
||||
- `reme/steps/evolve/dream.py`
|
||||
- `reme/steps/evolve/daily_topics.py`
|
||||
- 更新 `reme/steps/evolve/__init__.py`。
|
||||
|
||||
现在没有保留的迁移项:
|
||||
|
||||
- 不兼容 `interests.md`。
|
||||
- 不保留单文件 `dream path=...`。
|
||||
- 不保留 `dream_extract` job。
|
||||
- 不保留 `daily_topics` job。
|
||||
- 不要求 response metadata 兼容 `AutoDreamResult`。
|
||||
- 不要求 prompt 入参兼容旧 `dream.yaml`。
|
||||
|
||||
## 9. 推荐测试用例
|
||||
|
||||
最低测试集:
|
||||
|
||||
| 场景 | 期望 |
|
||||
|---|---|
|
||||
| 当天没有任何文件 | scanned=0,success=true,no topics |
|
||||
| 只有 day-index 新增 | `dream_extract_step` 调用一次全局 extract,finish checkpoint day-index |
|
||||
| session note 新增 | extract evidence 中 day-index first,session notes sorted |
|
||||
| session note mtime 未变 | unchanged+1,不进入 changed evidence |
|
||||
| session note 删除 | catalog delete |
|
||||
| `interests.yaml` 存在 | 不进入 scan/diff/changed evidence |
|
||||
| 多个文件产出同一抽象 | extract 输出 1 个 unit,`paths` 包含多个 source path |
|
||||
| extract 输出空 units/topics | finish 仍 checkpoint changed files,避免重复空跑 |
|
||||
| 某个 unit integrate 失败 | 该 unit 的 `paths` 不 checkpoint,response failure |
|
||||
| 同一 path 同时属于成功和失败 unit | 失败优先,该 path 不 checkpoint |
|
||||
| 其它 path 的 units 都成功 | 这些 path 可以 checkpoint |
|
||||
| 有 topic candidates | 写/更新 `daily/<date>/interests.yaml`,记录 topics_path/topics_written |
|
||||
| 已存在 `interests.yaml` | 合并新旧 topics,不重复 |
|
||||
| 最近 N 天已有相同 topic | 当前日 topics 去重跳过 |
|
||||
| extract 输出 unknown bucket | 清洗后 bucket=`wiki` |
|
||||
| prompt 输出 path 不在 changed paths | 该 unit 被丢弃或修正,不能 checkpoint 不明来源 |
|
||||
|
|
@ -1,80 +1,64 @@
|
|||
# ReMe 设计文档
|
||||
|
||||
> 本文按 `reme/` 目录最新代码整理,重点描述当前实现,而不是历史设想。
|
||||
|
||||
## 整体定位
|
||||
|
||||
> 一句话总结:**自进化的个人知识库**——你只管往里扔东西和对话,它自己长成一张知识图谱。
|
||||
一句话总结:**面向 Agent 的、文件优先的自进化记忆系统**。
|
||||
|
||||
## 特性1:记忆分层
|
||||
ReMe 把记忆落在一个可读、可编辑、可复制的 vault 目录里,用 Markdown、front matter、wikilink、BM25 倒排索引和后台 Agent 管线,把原始材料逐步沉淀为可检索、可追溯、可演化的长期记忆。
|
||||
|
||||
记忆按"原始 → 浅加工 → 深加工"三层组织:
|
||||
核心原则:
|
||||
|
||||
### 1.1 目录结构
|
||||
- **文件即记忆**:长期状态主要是 vault 下的文件和 `reme_metadata/` 中的索引快照。
|
||||
- **Agent 可操作**:所有能力通过 Job 暴露,Agent 可以用 HTTP、MCP 或 Python 直接调用。
|
||||
- **渐进加工**:对话和资源先进入 `daily/`,再由 `auto_dream` 提炼到 `digest/`。
|
||||
- **Obsidian 兼容**:Markdown、YAML front matter、`[[wikilink]]`、Dataview 风格属性都按文本文件保存。
|
||||
|
||||
```
|
||||
- reme_session/
|
||||
- agentscope|claude_code / # 使用内置的agent wrapper,session会保存在这里
|
||||
{session_id}.jsonl UUID格式要求 # /Users/yuli/workspace/ReMe/reme/components/agent_wrapper
|
||||
- dialog/
|
||||
{session_id}.jsonl # auto memory保存 可以监控可以被检索【可选】
|
||||
- resource/
|
||||
- YYYY-MM-DD/
|
||||
- {channel}_{xxxx}.html
|
||||
- {channel}_{xxxx}.md
|
||||
- daily/【日记,浅加工】
|
||||
- YYYY-MM-DD.md
|
||||
- YYYY-MM-DD/
|
||||
- session_{session_id}.md
|
||||
- {resource_stem}.md
|
||||
- digest/
|
||||
- personal/
|
||||
- procedure/
|
||||
- wiki/
|
||||
## 1. Vault 与记忆分层
|
||||
|
||||
默认目录来自 `ApplicationConfig`:
|
||||
|
||||
```text
|
||||
<vault_dir>/
|
||||
reme_metadata/ # ReMe 索引、图谱、catalog 等持久状态
|
||||
reme_session/ # Agent session 与原始对话
|
||||
dialog/
|
||||
<session_id>.jsonl # auto_memory 保存的对话消息
|
||||
agentscope/ # AgentScope wrapper session
|
||||
claude_code/ # Claude Code wrapper session
|
||||
resource/ # 外部原始材料
|
||||
YYYY-MM-DD/
|
||||
<resource>.<ext>
|
||||
daily/ # 浅加工记忆
|
||||
YYYY-MM-DD.md # 当天索引页
|
||||
YYYY-MM-DD/
|
||||
<session_id>.md # 对话或资源加工后的 daily note
|
||||
interests.yaml # auto_dream 产出的主动兴趣主题
|
||||
digest/ # 深加工记忆
|
||||
personal/
|
||||
procedure/
|
||||
wiki/
|
||||
```
|
||||
|
||||
### 1.2 分层详解
|
||||
分层含义:
|
||||
|
||||
| 目录 | 存什么 | 谁写入 | 举例 |
|
||||
|---------------------|----------------|-------------|-----------------------------------|
|
||||
| `resource/` | 原始文件(研报、网页、邮件) | upload / 手动 | PDF 研报、对话 JSONL |
|
||||
| `daily/` | 每天的事件记录 | auto-memory | "调试登录 CSS"、"与 Alice 聚餐" |
|
||||
| `digest/procedure/` | 方法论、步骤 | auto-dream | "webpack 编译卡死排查路径" |
|
||||
| `digest/personal/` | 用户画像、偏好 | auto-dream | "用户不爱写注释"、"用户喜欢 pnpm" |
|
||||
| `digest/wiki/` | 通用知识、决策先例 | auto-dream | "光伏产业链"、"React Server Components" |
|
||||
| 层级 | 内容 | 主要写入方 | 说明 |
|
||||
| --- | --- | --- | --- |
|
||||
| `resource/` | 原始文本材料 | 手动、外部同步 | 当前 `auto_resource` 支持文本类资源读取:`md/txt/json/jsonl/csv/yaml/html` |
|
||||
| `reme_session/dialog/` | 原始对话 JSONL | `auto_memory` | 对话消息按 `session_id` 去重、合并、持久化,并在 daily note front matter 中溯源 |
|
||||
| `daily/` | 日记、资源解读、当天索引、兴趣主题 | `daily_create`、`auto_memory`、`auto_resource`、`auto_dream` | 浅加工层,保留当天发生的事实和材料 |
|
||||
| `digest/personal/` | 用户画像、偏好、长期个人事实 | `auto_dream` | 深加工记忆桶之一 |
|
||||
| `digest/procedure/` | 方法论、流程、操作经验 | `auto_dream` | 深加工记忆桶之一 |
|
||||
| `digest/wiki/` | 通用知识、概念、决策先例 | `auto_dream` | 深加工记忆桶之一 |
|
||||
|
||||
`resource/` 和 `daily/` 是只增不删的流水账;`digest/` 下三个桶是反复消费的精华层,各桶有独立的整合 prompt。
|
||||
启动时 `Application` 会确保 vault 根目录和上述主要子目录存在。
|
||||
|
||||
## 特性2:Obsidian 兼容的 Markdown 格式
|
||||
## 2. Markdown 与图谱格式
|
||||
|
||||
所有笔记都是标准 Markdown + Obsidian 语法,可以直接用 Obsidian 打开浏览:
|
||||
### 2.1 Front Matter
|
||||
|
||||
```
|
||||
┌─────────────────────────────────────────────────────────────┐
|
||||
│ 一个 .md 文件的完整结构 │
|
||||
├─────────────────────────────────────────────────────────────┤
|
||||
│ --- │
|
||||
│ name: 宁德时代 ← YAML front matter │
|
||||
│ description: 全球动力电池龙头 │
|
||||
│ tags: [新能源, 电池] │
|
||||
│ --- │
|
||||
├─────────────────────────────────────────────────────────────┤
|
||||
│ 所属行业:: [[新能源]] ← 语义化链接(Dataview) │
|
||||
│ 竞争对手:: [[比亚迪]] │
|
||||
│ │
|
||||
│ # 基本面 ← Markdown 正文 │
|
||||
│ 全球动力电池出货量第一,核心技术为 │
|
||||
│ [[CTP]] 和 [[钠离子电池]]…… ← 标准 wikilink │
|
||||
│ │
|
||||
│ 参考 ![[2026Q1调研纪要]] ← 嵌入引用 │
|
||||
├─────────────────────────────────────────────────────────────┤
|
||||
│ ↓ AST 语义分块 ↓ │
|
||||
│ chunk 1: [标题骨架] + 正文片段 │
|
||||
│ chunk 2: [标题骨架] + 正文片段 │
|
||||
└─────────────────────────────────────────────────────────────┘
|
||||
```
|
||||
|
||||
### 2.1 YAML front matter
|
||||
|
||||
每个笔记头部的元数据:
|
||||
Markdown 文件可带 YAML front matter:
|
||||
|
||||
```markdown
|
||||
---
|
||||
|
|
@ -84,306 +68,419 @@ tags: [新能源, 光伏, 产业链]
|
|||
---
|
||||
```
|
||||
|
||||
`name` / `description` 是约定字段,其余键值对全部保留,不会丢弃任何自定义字段。
|
||||
当前 `FileFrontMatter` 约定 `name`、`description` 等字段;写入类 Job 会保留并合并 metadata。索引时,front matter 会进入 `FileNode.front_matter`,供 `node_search`、图展开和 Agent 判断使用。
|
||||
|
||||
### 2.2 四种 wikilink 写法
|
||||
### 2.2 Wikilink
|
||||
|
||||
| 写法 | 示例 | 语义 |
|
||||
|------|----------------|----------|
|
||||
| 标准链接 | `[[光伏产业链]]` | 指向目标文件 |
|
||||
| 锚点链接 | `[[钴#应用]]` | 指向特定章节 |
|
||||
| 别名链接 | `[[宁德时代\|宁德]]` | 自定义显示文本 |
|
||||
| 嵌入引用 | `![[钴]]` | 内联嵌入目标内容 |
|
||||
`WikilinkHandler` 是系统唯一的 wikilink 解析和改写入口。支持:
|
||||
|
||||
### 2.3 语义化链接(Dataview 风格)
|
||||
| 写法 | 示例 | 含义 |
|
||||
| --- | --- | --- |
|
||||
| 标准链接 | `[[digest/wiki/光伏.md]]` | 指向 vault-relative 目标 |
|
||||
| 锚点链接 | `[[digest/wiki/钴.md#应用]]` | 指向目标章节 |
|
||||
| 别名链接 | `[[digest/wiki/宁德时代.md\|宁德]]` | 显示别名,目标不变 |
|
||||
| 嵌入引用 | `![[resource/2026-06-01/report.md]]` | 作为 wikilink 记录边 |
|
||||
| 行级属性 | `industry:: [[digest/wiki/新能源.md]]` | 提取 predicate |
|
||||
| 内联属性 | `[competitor:: [[digest/wiki/比亚迪.md]]]` | 提取 predicate |
|
||||
|
||||
普通 wikilink 只说"A 提到了 B",语义化链接还能表达"A 和 B 是什么关系":
|
||||
当前实现采取**字面路径语义**:`[[X]]` 的 target 就是 `X`,不会自动补 `.md`,不会做 basename 搜索,也不会做 folder note 解析。推荐使用带扩展名的 vault-relative 路径。
|
||||
|
||||
```markdown
|
||||
所属行业:: [[新能源]] ← 行级属性(独占一行)
|
||||
总部:: [[宁德]]
|
||||
[竞争对手:: [[比亚迪]]] ← 内联属性(嵌入正文中)
|
||||
### 2.3 图谱边
|
||||
|
||||
Markdown chunker 会从正文提取 `FileLink`:
|
||||
|
||||
```text
|
||||
source_path # 源文件
|
||||
target_path # wikilink 里的字面目标
|
||||
target_anchor # # 后的锚点,可为空
|
||||
predicate # Dataview 风格关系名,可为空
|
||||
```
|
||||
|
||||
`WikilinkHandler` 是全系统唯一的 wikilink 解析入口,确保 parser、graph、search 各层规则一致。
|
||||
`file_graph` 维护:
|
||||
|
||||
### 2.4 AST 感知的语义分块
|
||||
- 节点:`FileNode(path, st_mtime, links, chunk_ids, front_matter)`
|
||||
- 正向边:文件里的 outlinks
|
||||
- 反向边:谁指向当前节点
|
||||
- pending 边:目标文件暂不存在时先保留为 virtual link,目标出现后自动提升为 real link
|
||||
|
||||
传统 RAG 按固定 token 长度切片,经常切坏文档结构。ReMe 基于 Markdown AST 做语义分块:
|
||||
`move` 默认会调用 `WikilinkHandler.retarget_links`,把入边来源文件中的 `[[src]]` 字面链接改写为 `[[dst]]`;`delete` 会返回仍然存在的入边,提示调用方清理引用。
|
||||
|
||||
- 按 H1/H2/H3 章节嵌套建树,递归分块
|
||||
- **每个 chunk 保留完整标题骨架**——检索到片段后一眼看出它在哪个章节下
|
||||
- 表格自动重复表头、代码块保留 fence、列表按项打包
|
||||
## 3. 语义分块与索引
|
||||
|
||||
```
|
||||
示例 chunk:
|
||||
─────────────────────
|
||||
# 光伏产业链
|
||||
## 上游:硅料
|
||||
### 多晶硅工艺
|
||||
[chunk 正文] ← 实际内容
|
||||
## 中游:硅片 ← 骨架(只有标题)
|
||||
## 下游:组件
|
||||
─────────────────────
|
||||
### 3.1 Markdown AST 分块
|
||||
|
||||
`MarkdownFileChunker` 使用 `mistletoe` 构建 Markdown AST,再按标题层级折叠成树:
|
||||
|
||||
```text
|
||||
Document AST
|
||||
-> MdNode root
|
||||
-> section H1
|
||||
-> body paragraph/list/table/code
|
||||
-> section H2
|
||||
```
|
||||
|
||||
## 特性3:自进化
|
||||
分块策略:
|
||||
|
||||
> **ReMe 的记忆不是被动存的,是主动长成知识图谱的。**
|
||||
- 按 H1/H2/H3 等章节递归分块。
|
||||
- 每个 chunk 默认包含完整标题骨架,检索命中后能看到片段在文档中的位置。
|
||||
- 表格拆分时重复表头和分隔行。
|
||||
- 代码块拆分时重复 fence opener/closer。
|
||||
- 列表按 item 打包。
|
||||
- 过长叶子节点按行或内部单元拆分,并加 `[Part X/N]`。
|
||||
- `chunk_chars` 默认 10000,`embed_toc` 默认开启。
|
||||
|
||||
```
|
||||
用户对话 / 外部素材
|
||||
│
|
||||
├───────────────────────────────────┐
|
||||
▼ ▼
|
||||
┌────────────┐ ┌────────────┐
|
||||
│ auto-memory│ │auto-resource│
|
||||
│ 对话→日记 │ │ 素材→解析 │
|
||||
└─────┬──────┘ └──────┬─────┘
|
||||
│ │
|
||||
▼ ▼
|
||||
┌─────────────────────────────────────────────────┐
|
||||
│ daily/ │
|
||||
│ (事件日记 + resource 加工笔记) │
|
||||
└─────────────────────┬───────────────────────────┘
|
||||
│
|
||||
▼ 定时触发
|
||||
┌─────────────┐
|
||||
│ auto-dream │
|
||||
│ 提炼 + 建图谱 │
|
||||
└──────┬──────┘
|
||||
│
|
||||
▼
|
||||
┌─────────────────────────────────────────────────┐
|
||||
│ digest/ │
|
||||
│ (知识卡片 + wikilink 互联 = 知识图谱) │
|
||||
└─────────────────────────────────────────────────┘
|
||||
`DefaultFileChunker` 用于非 Markdown 的默认文本切块,默认配置中主要覆盖 `jsonl`。
|
||||
|
||||
### 3.2 FileStore 组合
|
||||
|
||||
`LocalFileStore` 是当前默认文件索引协调层,组合:
|
||||
|
||||
| 子组件 | 默认后端 | 功能 |
|
||||
| --- | --- | --- |
|
||||
| `file_graph` | `local` | 节点、wikilink 正反向图谱 |
|
||||
| `keyword_index` | `bm25` | BM25 全文检索 |
|
||||
|
||||
默认 `reme/config/default.yaml` 中:
|
||||
|
||||
```yaml
|
||||
file_store:
|
||||
default:
|
||||
backend: local
|
||||
keyword_index: default
|
||||
file_graph: default
|
||||
```
|
||||
|
||||
用户什么都不用做,Agent 在后台让笔记自己长出结构。
|
||||
因此最新默认行为是:**BM25 + 图谱**。
|
||||
|
||||
### 3.1 auto-resource
|
||||
### 3.3 BM25 Index
|
||||
|
||||
监控 `resource/` 目录,新文件进来后自动解析内容、整理为结构化笔记写入 `daily/` 下。
|
||||
`BM25Index` 是 numpy 实现的倒排索引:
|
||||
|
||||
### 3.2 auto-memory
|
||||
- tokenizer 默认是 `regex`。
|
||||
- 文档级 lazy delete,更新时先退休旧 doc slot,再追加新 slot。
|
||||
- 持久化到 `reme_metadata/keyword_index/bm25_<name>_<tokenizer>_<fingerprint>_v1.pkl`。
|
||||
- tokenizer 配置和 stopwords 指纹进入索引文件名,避免不同分词配置复用错误索引。
|
||||
|
||||
对话进行时,ReMe 在后台把上下文自动写入当天日记。不是简单的对话摘要——而是一个拥有完整读写能力的 LLM
|
||||
Agent,自己决定记什么、怎么组织、合并还是新增。
|
||||
### 3.4 Search
|
||||
|
||||
### 3.3 auto-dream + auto-link:睡眠式记忆整理
|
||||
`search` Job 当前实现:
|
||||
|
||||
借鉴人在睡眠中巩固记忆的机制——把日记和素材提炼成知识卡片,并自动织出图谱关系:
|
||||
1. 读取 query、limit、min_score、search_filter。
|
||||
2. 默认配置下执行 `keyword_search`,返回 BM25 命中的 chunk。
|
||||
3. 按 `min_score` 过滤并截断到 limit。
|
||||
4. 对命中的唯一 path 做 link expansion,默认每个方向最多 10 条。
|
||||
5. 返回 chunk 正文、行号、分数和出入链目录。
|
||||
|
||||
```
|
||||
┌───────────────────────────┐
|
||||
│ daily/2026-05-28/xxx.md │ ← 一篇日记或素材
|
||||
└─────────────┬─────────────┘
|
||||
│
|
||||
╔═════════════════════════════════════╗
|
||||
║ Phase 1 — Extract(一个 Agent) ║
|
||||
║ "这份材料教了什么道理?" ║
|
||||
║ ║
|
||||
║ 输出 N 个抽象单元,各带 bucket 标签 ║
|
||||
║ (空 → 结束,没东西值得记) ║
|
||||
╚══════════╤══════════╤═══════════════╝
|
||||
│ │
|
||||
┌─────────────┘ └──────────────┐
|
||||
▼ ▼
|
||||
╔══════════════════════════════╗ ╔══════════════════════════════╗
|
||||
║ Phase 2 — Integrate ║ ║ Phase 2 — Integrate ║
|
||||
║ (每个 unit 独立一个 Agent) ║ ║ (每个 unit 独立一个 Agent) ║
|
||||
║ ║ ║ ║
|
||||
║ 1. search + traverse 召回 ║ ║ 1. search + traverse 召回 ║
|
||||
║ 2. 决策: CREATE / UPDATE ║ ║ 2. 决策: CREATE / UPDATE ║
|
||||
║ 3. 写入 + 自动织链接 ║ ║ 3. 写入 + 自动织链接 ║
|
||||
╚══════════════╤═══════════════╝ ╚══════════════╤═══════════════╝
|
||||
│ │
|
||||
▼ ▼
|
||||
┌──────────────────────────────────────────────────────────────┐
|
||||
│ digest/ │
|
||||
│ procedure/key-rotation.md ←─ derived_from:: [[daily/..]] │
|
||||
│ wiki/credential-compliance.md ─ relates_to:: [[...]] │
|
||||
│ personal/user-pr-pref.md │
|
||||
└──────────────────────────────────────────────────────────────┘
|
||||
知识图谱自动生长
|
||||
### 3.5 Node Search
|
||||
|
||||
`node_search` 是给 `auto_dream` Phase 2 使用的专用召回:
|
||||
|
||||
- 只返回 `digest/` 下节点。
|
||||
- 以 path 聚合 chunk 结果,一篇 digest 只返回一行。
|
||||
- 返回 path、score、front matter 中的 name/description。
|
||||
- 不返回正文,不做 link expansion。
|
||||
- 供集成 Agent 判断是 CREATE、CORROBORATE、REFINE 还是 CORRECT。
|
||||
|
||||
外部问答 Agent 应使用 `search`;dream 集成应使用 `node_search`。
|
||||
|
||||
## 4. 自进化管线
|
||||
|
||||
### 4.1 Auto Memory
|
||||
|
||||
`auto_memory` 输入对话 messages 和可选 `session_id`:
|
||||
|
||||
1. 把 messages 标准化为 AgentScope `Msg`。
|
||||
2. 如有 `session_id`,保存到 `reme_session/dialog/<session_id>.jsonl`。
|
||||
3. 调用 `daily_create` 创建或复用 `daily/<date>/<session_id>.md`,空 session 时使用 `daily/<date>.md`。
|
||||
4. 通过 `agent_wrapper` 调用 LLM Agent,工具集为 `read`、`edit`、`frontmatter_update`、`write`。
|
||||
5. 如果有 `session_id`,在 note front matter 写入 `source_conversation: [[reme_session/dialog/<session_id>.jsonl]]`。
|
||||
6. 刷新当天索引页 `daily/<date>.md`。
|
||||
|
||||
保存对话时会去掉 base64 数据块,并截断超长 tool result,避免 session JSONL 过大。
|
||||
|
||||
### 4.2 Auto Resource
|
||||
|
||||
`auto_resource` 处理 `resource/` 下的变更批次。默认后台 `resource_watch_loop` 监听:
|
||||
|
||||
```yaml
|
||||
watch_dirs: [resource_dir]
|
||||
watch_suffixes: [md, txt, json, jsonl, csv, yaml, html]
|
||||
```
|
||||
|
||||
**Phase 1 筛选**——多个事实说明同一个道理就合并为一个 unit,分到三个桶:`procedure`(怎么做)/ `personal`(用户偏好)/ `wiki`
|
||||
(通用知识)。没东西值得记则流程结束。
|
||||
资源路径约定为:
|
||||
|
||||
**Phase 2 先搜后写**——先搜已有 digest,再决策:新建(CREATE)、追加佐证(CORROBORATE)、补充精度(REFINE)、修正矛盾(CORRECT)。
|
||||
|
||||
**auto-link 是写入的副产品**——写 digest 时自动加 `derived_from:: [[素材]]` 溯源 + `relates_to::` 概念互联,图谱随每次
|
||||
dream 自动变密。
|
||||
|
||||
**CronDreamer 定时批跑**——每天扫描当天所有 daily + resource 文件,逐个执行上述管线。
|
||||
|
||||
## 特性4:混合索引 + 渐进式展开
|
||||
|
||||
```
|
||||
用户提问: "宁德时代的电池技术?"
|
||||
│
|
||||
├──────────────────────┬──────────────────────────┐
|
||||
▼ ▼ │
|
||||
┌─────────────────┐ ┌──────────────────┐ │
|
||||
│ 全文倒排索引 │ │ 向量索引 │ │
|
||||
│ (numpy + jieba) │ │ (faiss) │ │
|
||||
│ │ │ │ │
|
||||
│ "宁德时代" 精确 │ │ "动力电池龙头" │ │
|
||||
│ 命中 │ │ 语义近似命中 │ │
|
||||
└────────┬────────┘ └────────┬─────────┘ │
|
||||
│ text_weight=0.3 │ vector_weight=0.7 │
|
||||
└──────────┬──────────┘ │
|
||||
▼ │
|
||||
┌───────────────┐ │
|
||||
│ RRF 融合排序 │ │
|
||||
│ score = Σ(w/(k+rank)) │
|
||||
└───────┬───────┘ │
|
||||
▼ │
|
||||
┌──────────────────────────────────────┐ │
|
||||
│ 第一跳:Top-K chunk 全文 + 评分 │ │
|
||||
└───────────────────┬──────────────────┘ │
|
||||
▼ │
|
||||
┌──────────────────────────────────────┐ │
|
||||
│ 第二跳:邻居目录(只有标题,不展开正文)│ ← wikilink 图谱 │
|
||||
└───────────────────┬──────────────────┘ │
|
||||
▼ │
|
||||
┌──────────────────────────────────────┐ │
|
||||
│ 第 N 跳:Agent 按需追问,展开正文 │ │
|
||||
└──────────────────────────────────────┘ │
|
||||
```text
|
||||
resource/YYYY-MM-DD/<filename>
|
||||
```
|
||||
|
||||
### 4.1 混合索引构建
|
||||
处理逻辑:
|
||||
|
||||
两套索引并行维护,各擅其长:
|
||||
- `added/modified`:读取原始资源文本,创建或更新 `daily/YYYY-MM-DD/<resource_stem>.md`,再由 Agent 解读资源内容并写入 daily note。
|
||||
- `deleted`:删除对应 daily note,更新 file_store,并刷新当天索引页。
|
||||
- Agent session id 使用资源路径的 UUID5,保证同一资源重复处理时会话稳定。
|
||||
|
||||
- **全文倒排索引**(基于numpy)——精确匹配专有名词,搜"宁德时代"必须命中。支持增量更新索引,无原生扩展依赖。
|
||||
- **向量索引**(基于faiss)——语义相似度,搜"锂电正极原料"能命中"钴"。
|
||||
### 4.3 Auto Dream
|
||||
|
||||
### 4.2 基于 RRF 的混合检索
|
||||
`auto_dream` 是最新代码中的四步 Job:
|
||||
|
||||
两条通路并行跑(`asyncio.gather`),用 RRF(Reciprocal Rank Fusion)融合排序:
|
||||
|
||||
```
|
||||
融合分 = Σ( weight_i / (k + rank_i) ) k=60, vector_weight=0.7, text_weight=0.3
|
||||
```yaml
|
||||
auto_dream:
|
||||
steps:
|
||||
- dream_extract_step
|
||||
- dream_integrate_step
|
||||
- dream_topics_step
|
||||
- dream_finish_step
|
||||
```
|
||||
|
||||
为什么要两路?纯向量容易错配名词("苹果公司"≈"水果"),纯关键词抓不到同义改写——融合互补盲区。
|
||||
它的目标是扫描某天 daily 输入,把值得长期保留的抽象记忆写入 `digest/`,同时生成当天的 `interests.yaml`。
|
||||
|
||||
### 4.3 渐进式链接展开
|
||||
#### Phase 1: Extract
|
||||
|
||||
传统 RAG 一次性把 Top-K 全塞进上下文,token 浪费且噪音多。ReMe 分跳展开,按需深入:
|
||||
`dream_extract_step`:
|
||||
|
||||
**第一跳** — 返回命中 chunk 全文 + 分数明细
|
||||
- 刷新当天索引页。
|
||||
- 扫描 `daily/<date>.md` 和 `daily/<date>/` 下文件,但排除 `interests.yaml`。
|
||||
- 用 `file_catalog:dream` 对比 mtime,只处理 changed paths。
|
||||
- 如果没有变化,直接结束。
|
||||
- 调用 Agent 读取 changed material,输出:
|
||||
- `units`: 需要进入 digest 的抽象记忆单元。
|
||||
- `topics`: 主动兴趣主题候选。
|
||||
- unit bucket 限定为 `procedure`、`personal`、`wiki`,未知 bucket 会路由到 `wiki`。
|
||||
|
||||
**第二跳** — 展开 wikilink 邻居的"目录"(只有标题,不展开正文):
|
||||
#### Phase 2: Integrate
|
||||
|
||||
```
|
||||
========== digest/wiki/宁德时代.md:5-22 [score=0.0247 vector=0.0156 keyword=0.0091] ==========
|
||||
# 宁德时代
|
||||
全球动力电池出货量第一,核心技术为 CTP(Cell to Pack)和钠离子电池……
|
||||
`dream_integrate_step` 对每个 unit 独立调用 Agent:
|
||||
|
||||
outlinks (2):
|
||||
→ digest/wiki/磷酸铁锂.md name="磷酸铁锂正极路线" description="磷酸铁锂与三元路线对比" via predicate=相关技术
|
||||
→ digest/wiki/固态电池.md name="固态电池技术路线" description="全固态与半固态进展" via predicate=技术演进
|
||||
inlinks (2):
|
||||
← daily/2026-03-18/宁德调研.md name="宁德时代调研纪要" description="2026Q1产能与订单跟踪" via plain
|
||||
← digest/wiki/新能源产业链.md name="新能源产业链全景" description="从锂矿到整车的全链条" via predicate=下游应用
|
||||
- Agent 可用工具:`node_search`、`read`、`frontmatter_read`、`write`、`edit`、`frontmatter_update`。
|
||||
- 先召回 digest 中可能相同或相关的节点。
|
||||
- 决策结果是结构化 `IntegrateOutcome`:
|
||||
|
||||
| action | 含义 |
|
||||
| --- | --- |
|
||||
| `CREATE` | 新建 digest 节点 |
|
||||
| `CORROBORATE` | 给已有节点追加佐证 |
|
||||
| `REFINE` | 补充更精确的表述 |
|
||||
| `CORRECT` | 修正旧记忆中的矛盾或过时内容 |
|
||||
|
||||
失败 unit 会记录到 `failed_units` 和 `failed_paths`,不会被 checkpoint,后续运行会重试。
|
||||
|
||||
#### Phase 3: Topics
|
||||
|
||||
`dream_topics_step` 写入:
|
||||
|
||||
```text
|
||||
daily/<date>/interests.yaml
|
||||
```
|
||||
|
||||
**第 N 跳** — Agent 看过"目录"后,自己决定哪些邻居值得深入,再发起 read 拿正文。
|
||||
默认最多保留 3 个 topic,并参考过去 7 天的 `interests.yaml` 做去重,避免每天重复推送同类兴趣。若 LLM 不可用,会退化为本地去重选择。
|
||||
|
||||
二跳目录每条只占一行(最多 10 outlink + 10 inlink),Agent 拥有全局视野却不撑爆上下文。
|
||||
#### Phase 4: Finish
|
||||
|
||||
## 特性5:多 Agent 框架集成
|
||||
`dream_finish_step`:
|
||||
|
||||
ReMe 不做独立 Agent 产品,而是作为**能力层**被任意框架调用:
|
||||
- 把成功处理的 changed paths、`interests.yaml` 和当天索引页写入 `file_catalog:dream`。
|
||||
- 删除 catalog 中已经不存在的 daily 输入。
|
||||
- 持久化 catalog 到 `reme_metadata/file_catalog/dream.jsonl.zst`。
|
||||
- 返回本次扫描、抽取、集成、topic 和 checkpoint 的摘要。
|
||||
|
||||
| 集成路径 | 适用对象 | 方式 |
|
||||
|---------------------|----------------------|---------------------------------------------|
|
||||
| SDK 深度集成 | AgentScope / Qwenpaw | middleware 注册 tools + prompt,hook 注册 auto-* |
|
||||
| MCP Tool + skill.md | Claude Code | MCP 注册 Tool,配 skill.md 开箱即用,hook 注册 auto-* |
|
||||
| HTTP API + CLI | 通用方案 | skill.md + CLI 调用 |
|
||||
### 4.4 Proactive
|
||||
|
||||
---
|
||||
`proactive` 读取当天或指定日期的:
|
||||
|
||||
# 二、工程架构
|
||||
|
||||
```
|
||||
┌─────────────────────────────────────────────────────────────────┐
|
||||
│ Service 层(HTTP / MCP 双协议) │
|
||||
│ FastAPI + FastMCP,同一套 Job 同时暴露为 REST 和 MCP Tool │
|
||||
├─────────────────────────────────────────────────────────────────┤
|
||||
│ Application 层 │
|
||||
│ 配置加载 → 组件初始化 → Job 注册 → start() / close() 生命周期 │
|
||||
├─────────────────────────────────────────────────────────────────┤
|
||||
│ Job 层(编排) │
|
||||
│ 每个 Job = 一组 Step 的有序管线,YAML 声明式配置 │
|
||||
├─────────────────────────────────────────────────────────────────┤
|
||||
│ Step 层(业务逻辑) │
|
||||
│ 原子操作单元,按功能域分组:file_io / index / evolve / common │
|
||||
├─────────────────────────────────────────────────────────────────┤
|
||||
│ Component 层(可插拔基础设施) │
|
||||
│ 统一注册表 R,一行配置切换实现 │
|
||||
│ file_store / embedding / keyword_index / llm / file_graph │
|
||||
└─────────────────────────────────────────────────────────────────┘
|
||||
```text
|
||||
daily/<date>/interests.yaml
|
||||
```
|
||||
|
||||
## 2.1 服务层
|
||||
返回 topics 和可选 YAML 原文,供调用方读取当天兴趣主题。
|
||||
|
||||
每个 Job 同时暴露为两种协议,写一次逻辑、两种方式调用:
|
||||
## 5. Job、Step 与组件架构
|
||||
|
||||
| 协议 | 传输方式 | 适用场景 |
|
||||
|---------------|-------------------------------|------------------------------|
|
||||
| HTTP(FastAPI) | JSON POST / SSE | REST 调用、Web 前端 |
|
||||
| MCP(FastMCP) | stdio / SSE / streamable-http | Claude Code、Cursor 等 MCP 客户端 |
|
||||
### 5.1 分层
|
||||
|
||||
- **按需拉起**:Agent 检测到服务未运行时自动后台启动,用户无感知
|
||||
- **服务发现**:通过 `REME_SERVICE_INFO` 环境变量广播地址,`find_reme` 一键探活
|
||||
```text
|
||||
Service 层
|
||||
HTTP / MCP,把 Job 暴露为外部接口
|
||||
|
||||
## 2.2 组件系统(Component)
|
||||
Application 层
|
||||
加载配置,初始化 service、component、job,按依赖拓扑启动组件
|
||||
|
||||
统一注册表 `R`,所有基础设施都是可插拔的——改一行配置就能切换后端:
|
||||
Job 层
|
||||
BaseJob / StreamJob / BackgroundJob / CronJob,按 YAML 顺序执行 Step
|
||||
|
||||
| 组件 | 干什么 | 可选后端 |
|
||||
|-----------------|---------------|-----------------------|
|
||||
| file_store | 文件存储 + 索引协调 | local |
|
||||
| file_graph | wikilink 双向图谱 | local / nx / neo4j |
|
||||
| keyword_index | 全文倒排索引 | bm25(numpy + jieba) |
|
||||
| embedding_store | 向量存储与检索 | local(faiss) |
|
||||
| embedding | 文本转向量 | openai 兼容接口 |
|
||||
| llm | 大模型调用 | anthropic / openai 兼容 |
|
||||
| tokenizer | 分词 | regex / jieba |
|
||||
Step 层
|
||||
默认 Job 使用的原子业务操作:file_io / index / evolve / common
|
||||
|
||||
## 2.3 Job 列表
|
||||
Component 层
|
||||
可插拔基础设施:store、graph、index、catalog、LLM、agent wrapper、tokenizer
|
||||
```
|
||||
|
||||
**Job** 是 ReMe 暴露给外部的操作单元——同一个 Job 可以作为 Python 函数直接调用、作为 MCP Tool 被 Agent 使用、也可以作为 CLI
|
||||
命令执行。
|
||||
### 5.2 Registry 与依赖注入
|
||||
|
||||
| 类别 | Job | 功能 |
|
||||
|------|---------------------------|----------------------------------|
|
||||
| 检索 | `search` | 混合检索(向量 + BM25 + RRF)+ 渐进式图展开 |
|
||||
| 检索 | `traverse` | 从指定路径遍历 wikilink 图谱 |
|
||||
| 文件读写 | `read` | 读取 markdown 文件内容 |
|
||||
| 文件读写 | `read_image` | 读取图片文件(base64) |
|
||||
| 文件读写 | `write` | 新建或覆写 markdown 文件(含 frontmatter) |
|
||||
| 文件读写 | `edit` | 文件内查找替换 |
|
||||
| 文件读写 | `delete` | 删除文件,返回残留入边 |
|
||||
| 文件读写 | `move` | 移动 / 重命名,自动重写 wikilink |
|
||||
| 文件读写 | `list` | 列出目录下文件 |
|
||||
| 文件读写 | `stat` | 文件元信息(大小、修改时间) |
|
||||
| 文件读写 | `frontmatter_read` | 读取 frontmatter |
|
||||
| 文件读写 | `frontmatter_update` | 合并更新 frontmatter |
|
||||
| 文件读写 | `frontmatter_delete` | 删除 frontmatter 字段 |
|
||||
| 日记管理 | `daily_create` | 幂等创建当天日记文件 |
|
||||
| 日记管理 | `daily_list` | 列出某天的所有日记 |
|
||||
| 日记管理 | `daily_reindex` | 重建当天索引页 |
|
||||
| 索引维护 | `reindex` | 清空并全量重建索引 |
|
||||
| 索引维护 | `update_store_index_loop` | 后台监听文件变更,增量更新 |
|
||||
| 自进化 | `auto_memory` | 对话记录写入日记(LLM Agent) |
|
||||
| 自进化 | `dream` | 单文件记忆提炼到 digest(LLM Agent) |
|
||||
| 自进化 | `auto-dream` | 批量扫描当天文件,逐个 dream |
|
||||
| 系统 | `health_check` | 组件健康检查 |
|
||||
| 系统 | `version` | 返回版本号 |
|
||||
| 系统 | `help` | 列出所有已注册 Job |
|
||||
所有后端通过全局注册表 `R` 注册:
|
||||
|
||||
```python
|
||||
@R.register("local")
|
||||
class LocalFileStore(BaseFileStore):
|
||||
...
|
||||
```
|
||||
|
||||
配置中的 `backend` 会通过 `(ComponentEnum, backend)` 找到类。组件依赖通过 `BaseComponent.bind(name, BaseClass)` 声明,`Application` 会按依赖拓扑顺序启动组件,并在关闭时反序关闭。
|
||||
|
||||
### 5.3 Job 类型
|
||||
|
||||
| Job 后端 | 类 | 行为 |
|
||||
| --- | --- | --- |
|
||||
| `base` | `BaseJob` | 请求触发,按步骤顺序执行,返回 `Response` |
|
||||
| `stream` | `StreamJob` | SSE/流式输出 chunk |
|
||||
| `background` | `BackgroundJob` | 应用启动后后台运行,失败时可 supervisor 重启 |
|
||||
| `cron` | `CronJob` | 按 cron 表达式定时执行步骤 |
|
||||
|
||||
后台 Job 强制 `enable_serve=False`,不会暴露成 HTTP endpoint 或 MCP tool。
|
||||
|
||||
### 5.4 默认 Job 列表
|
||||
|
||||
默认配置中的主要 Job:
|
||||
|
||||
| 类别 | Job | 说明 |
|
||||
| --- | --- | --- |
|
||||
| 后台索引 | `index_update_loop` | 监听 `daily/`、`digest/` 的 Markdown 变更,增量更新 file_store |
|
||||
| 后台资源 | `resource_watch_loop` | 监听 `resource/` 文本资源,更新 resource catalog 并触发 `auto_resource_step` |
|
||||
| 后台 catalog | `digest_watch_loop` | 监听 `daily/`、`digest/`,更新 digest catalog 并记录变更 |
|
||||
| 系统 | `version` | 返回包版本 |
|
||||
| 系统 | `health_check` | 返回组件健康快照 |
|
||||
| 系统 | `help` | 列出已注册 Job |
|
||||
| 检索 | `search` | chunk 级 BM25 检索和 link expansion |
|
||||
| 检索 | `node_search` | digest 节点级召回,供 dream 集成使用 |
|
||||
| 图谱 | `traverse` | 从指定 path 遍历 wikilink 图 |
|
||||
| 索引维护 | `reindex` | 清空 file_store 并从文件重新建索引 |
|
||||
| 日记 | `daily_create` | 幂等创建当天 day-level 或 session-level note |
|
||||
| 日记 | `daily_list` | 列出某天 daily notes |
|
||||
| 日记 | `daily_reindex` | 重建当天索引页 |
|
||||
| 文件读写 | `read` | 读取 vault 内 Markdown 文件,可指定行号 |
|
||||
| 文件读写 | `read_image` | 读取图片为 base64,默认上限 5MB |
|
||||
| 文件读写 | `write` | 写 Markdown 文件和 front matter |
|
||||
| 文件读写 | `edit` | 全量 find-and-replace |
|
||||
| 文件读写 | `delete` | 删除文件或目录,返回残留入边 |
|
||||
| 文件读写 | `move` | 移动或重命名文件,默认改写入边 wikilink |
|
||||
| 文件读写 | `list` | 列目录 |
|
||||
| 文件读写 | `stat` | 返回路径元信息 |
|
||||
| Front Matter | `frontmatter_read` | 读取 front matter |
|
||||
| Front Matter | `frontmatter_update` | 合并更新 front matter |
|
||||
| Front Matter | `frontmatter_delete` | 删除 front matter 字段 |
|
||||
| 自进化 | `auto_memory` | 对话写入 daily note |
|
||||
| 自进化 | `auto_resource` | 资源文件解读为 daily note |
|
||||
| 自进化 | `auto_dream` | daily -> digest + interests.yaml |
|
||||
| 主动记忆 | `proactive` | 读取 `interests.yaml` |
|
||||
|
||||
## 6. 服务、客户端与 CLI
|
||||
|
||||
### 6.1 HTTP Service
|
||||
|
||||
`HttpService` 使用 FastAPI:
|
||||
|
||||
- 非 stream Job 注册为 `POST /<job.name>`,请求体是 `Request`,响应是 `Response`。
|
||||
- StreamJob 注册为 `POST /<job.name>`,返回 `text/event-stream`。
|
||||
- CORS 默认开放。
|
||||
- lifespan 中启动/关闭整个 `Application`。
|
||||
|
||||
### 6.2 MCP Service
|
||||
|
||||
`MCPService` 使用 FastMCP:
|
||||
|
||||
- 非 stream Job 注册为 MCP tool。
|
||||
- 支持 `stdio`、`sse`、`streamable-http` 等 transport。
|
||||
- StreamJob 当前不注册为 MCP tool。
|
||||
|
||||
### 6.3 Client 与 CLI
|
||||
|
||||
入口是:
|
||||
|
||||
```bash
|
||||
reme start
|
||||
reme find_reme
|
||||
reme <job_name> key=value ...
|
||||
```
|
||||
|
||||
行为:
|
||||
|
||||
- `reme start`:加载 `.env`,解析配置,启动服务。
|
||||
- `reme find_reme`:从环境或默认地址探活。
|
||||
- 其他 action:通过 client 调用已运行服务,默认 HTTP,也可指定 `backend=mcp`。
|
||||
|
||||
配置解析支持:
|
||||
|
||||
- 默认加载 `reme/config/default.yaml`。
|
||||
- `config=<name-or-path>` 指定配置文件。
|
||||
- dot notation 覆盖,如 `service.port=8090`。
|
||||
- `${ENV_VAR:-default}` 环境变量展开。
|
||||
|
||||
服务启动后会把地址写到环境变量 `REME_SERVICE_INFO`,HTTP client 会优先使用显式 host/port,其次使用该环境变量,最后回落到默认 host/port。
|
||||
|
||||
## 7. 默认组件后端
|
||||
|
||||
默认配置中的组件:
|
||||
|
||||
| ComponentEnum | 名称 | 后端 | 说明 |
|
||||
| --- | --- | --- | --- |
|
||||
| `service` | - | `http` | 默认服务协议 |
|
||||
| `tokenizer` | `default` | `regex` | BM25 分词 |
|
||||
| `as_llm` | `default` | `${LLM_BACKEND:-openai}` | OpenAI 兼容 LLM,默认模型 `qwen3.7-plus` |
|
||||
| `agent_wrapper` | `default` | `agentscope` | AgentScope ReAct wrapper |
|
||||
| `agent_wrapper` | `claude_code` | `claude_code` | Claude Code wrapper |
|
||||
| `file_graph` | `default` | `local` | 纯 Python 图谱 |
|
||||
| `file_catalog` | `default/resource/digest/dream` | `local` | JSONL.zst catalog |
|
||||
| `file_chunker` | `markdown` | `markdown` | Markdown AST chunker |
|
||||
| `file_chunker` | `default` | `default` | 默认文本 chunker |
|
||||
| `keyword_index` | `default` | `bm25` | numpy BM25 |
|
||||
| `file_store` | `default` | `local` | graph + keyword |
|
||||
|
||||
## 8. 持久化状态
|
||||
|
||||
除 vault 正文文件外,ReMe 会在 `reme_metadata/` 下保存组件状态:
|
||||
|
||||
| 组件 | 持久化内容 |
|
||||
| --- | --- |
|
||||
| `file_store` | `file_chunks_<name>_v1.jsonl.zst`,保存 chunk 元数据 |
|
||||
| `file_graph` | `<name>.jsonl.zst`,保存 `FileNode` 和 links |
|
||||
| `keyword_index` | `bm25_*.pkl`,保存 vocab、posting list、doc meta |
|
||||
| `file_catalog` | `<catalog_name>.jsonl.zst`,保存已处理文件 mtime checkpoint |
|
||||
|
||||
`Application.close()` 会反序关闭组件,`LocalFileStore.close()` 会触发 chunk、keyword index、file graph dump。后台 catalog/dream finish 也会按需 dump catalog。
|
||||
|
||||
## 9. 关键数据模型
|
||||
|
||||
```text
|
||||
Response
|
||||
success: bool
|
||||
answer: str
|
||||
metadata: dict
|
||||
|
||||
FileNode
|
||||
path: str
|
||||
st_mtime: float
|
||||
links: list[FileLink]
|
||||
chunk_ids: list[str]
|
||||
front_matter: FileFrontMatter
|
||||
|
||||
FileChunk
|
||||
id: str # hash(path, start_line, end_line, text)
|
||||
path: str
|
||||
start_line: int
|
||||
end_line: int
|
||||
text: str
|
||||
metadata: dict
|
||||
scores: dict[str, float]
|
||||
|
||||
FileLink
|
||||
source_path: str
|
||||
target_path: str
|
||||
target_anchor: str | None
|
||||
predicate: str | None
|
||||
|
||||
DreamState
|
||||
date / changed_paths / unchanged_paths / deleted_paths
|
||||
units / topics
|
||||
integrate_results / failed_units / failed_paths
|
||||
interests_path / topics_written
|
||||
checkpoint_paths / errors / summary
|
||||
```
|
||||
|
|
|
|||
|
|
@ -1,231 +1,451 @@
|
|||
# ReMe 应用场景
|
||||
|
||||
## 金融场景:产业链知识库
|
||||
本文描述 ReMe 在真实 Agent 工作流里的使用方式。目录、Job 名称和能力边界按 `reme/` 最新代码整理。
|
||||
|
||||
**主角**:王分析师,新能源行业研究员,每天处理 10+ 篇研报、数十条产业新闻、若干场公司调研。
|
||||
ReMe 的共同模式是:
|
||||
|
||||
**痛点**:信息散落在飞书文档、PDF 研报、微信群消息、调研纪要里,"上次调研宁德时代时聊到的钴价话题"再也找不回来。
|
||||
|
||||
### 一周内 ReMe 自动织出的产业链图谱
|
||||
|
||||
---
|
||||
|
||||
#### Day 1(周一)盘后:素材摄入 + 对话
|
||||
|
||||
王分析师把今天看到的 3 篇研报扔进 `resource/`,又和 Agent 口述了对刚果(金)矿权变更的看法:
|
||||
|
||||
```
|
||||
对话片段:
|
||||
> 今天嘉能可发了三季报,钴产量同比下滑 18%……
|
||||
> 刚果(金)那边的政策变化,对洛阳钼业 KFM 矿的影响要重点跟……
|
||||
> 下游三元正极厂商已经开始转向高镍低钴方案……
|
||||
```text
|
||||
对话 / 外部材料
|
||||
|
|
||||
+--> auto_memory / auto_resource
|
||||
| 写入 daily/
|
||||
|
|
||||
+--> auto_dream
|
||||
| 从 daily/ 提炼 digest/{personal,procedure,wiki}/
|
||||
| 同时写 daily/<date>/interests.yaml
|
||||
|
|
||||
+--> search / node_search / read / traverse / proactive
|
||||
供 Agent 检索、联想、读取兴趣主题
|
||||
```
|
||||
|
||||
**auto-memory** 实时把对话写入当天日记;**auto-resource** 自动解析研报写入加工笔记:
|
||||
## 场景一:金融分析师的产业链知识库
|
||||
|
||||
**主角**:王分析师,新能源行业研究员。每天处理研报、产业新闻、公司调研和盘后口述。
|
||||
|
||||
**痛点**:信息散在文本研报、网页摘录、群消息、调研纪要和对话里。几天后再问“上次宁德调研里提到的钴价影响”,很难把原始事件、公司、材料路线和上游矿企串起来。
|
||||
|
||||
### Day 1:盘后对话和研报进入 Daily
|
||||
|
||||
王分析师把 3 篇研报同步到 `resource/2026-05-18/`,又和 Agent 口述:
|
||||
|
||||
```text
|
||||
今天嘉能可发了三季报,钴产量同比下滑 18%。
|
||||
刚果(金)矿权政策变化,对洛阳钼业 KFM 矿的影响要重点跟。
|
||||
下游三元正极厂商继续转向高镍低钴方案。
|
||||
```
|
||||
daily/
|
||||
├── 2026-05-18.md ← 当天索引页,汇总所有事件
|
||||
|
||||
ReMe 产生两类浅加工文件:
|
||||
|
||||
```text
|
||||
resource/
|
||||
└── 2026-05-18/
|
||||
├── session_001.md ← auto-memory 写入的对话日志
|
||||
│ (含嘉能可三季报、刚果金矿权、高镍化趋势等事件)
|
||||
├── resource_001.md ← auto-resource 对研报 1 的加工笔记
|
||||
├── resource_002.md ← 研报 2 加工笔记
|
||||
└── resource_003.md ← 研报 3 加工笔记
|
||||
├── glencore-q3.md
|
||||
├── cobalt-policy.md
|
||||
└── cathode-trend.md
|
||||
|
||||
reme_session/
|
||||
└── dialog/
|
||||
└── 2026-05-18-close.jsonl
|
||||
|
||||
daily/
|
||||
├── 2026-05-18.md
|
||||
└── 2026-05-18/
|
||||
├── 2026-05-18-close.md
|
||||
├── glencore-q3.md
|
||||
├── cobalt-policy.md
|
||||
├── cathode-trend.md
|
||||
└── interests.yaml # auto_dream 后生成
|
||||
```
|
||||
|
||||
**Day 1 夜间 auto-dream**——CronDreamer 扫描当天 4 个文件,逐个执行 Extract → Integrate 管线:
|
||||
对应链路:
|
||||
|
||||
处理 `session_001.md`:
|
||||
- **Phase 1 Extract**:从对话日志中提取 3 个抽象单元——「嘉能可钴产量下滑」(wiki)、「刚果金矿权政策风险」(wiki)、「三元正极高镍化趋势」(wiki)
|
||||
- **Phase 2 Integrate**(每个 unit 独立一个 Agent):
|
||||
- 搜索已有 digest,均无匹配 → 决策 **CREATE**
|
||||
- 新建 `digest/wiki/嘉能可.md`、`digest/wiki/钴.md`、`digest/wiki/三元正极.md`
|
||||
- 写入时自动织链接:`derived_from:: [[daily/2026-05-18/session_001]]`,以及概念互联 `relates_to:: [[三元正极]]`
|
||||
- `auto_memory` 保存原始对话到 `reme_session/dialog/<session_id>.jsonl`,再让 Agent 把重要事实写入 `daily/<date>/<session_id>.md`。
|
||||
- `resource_watch_loop` 监听 `resource/` 文本文件变化,并触发 `auto_resource_step` 写同名 daily note。
|
||||
- `daily_create` 会维护 `daily/<date>.md` 当天索引页。
|
||||
|
||||
处理 `resource_001.md`(嘉能可三季报):
|
||||
- **Phase 1**:提取「嘉能可钴业务财务数据」(wiki)
|
||||
- **Phase 2**:搜索到刚刚新建的 `digest/wiki/嘉能可.md` → 决策 **CORROBORATE**,追加财务佐证段落
|
||||
### Day 1 晚上:Auto Dream 进入 Digest
|
||||
|
||||
Day 1 结束时 `digest/wiki/` 下新增:
|
||||
运行:
|
||||
|
||||
```
|
||||
digest/wiki/
|
||||
├── 嘉能可.md ← CREATE + CORROBORATE(研报佐证)
|
||||
├── 钴.md ← CREATE
|
||||
└── 三元正极.md ← CREATE
|
||||
```bash
|
||||
reme auto_dream date=2026-05-18
|
||||
```
|
||||
|
||||
`钴.md` 长这样:
|
||||
`auto_dream` 是四步管线:
|
||||
|
||||
```text
|
||||
dream_extract_step
|
||||
扫描 daily/2026-05-18.md 和 daily/2026-05-18/ 下 changed 文件
|
||||
输出 units 和 topics
|
||||
|
||||
dream_integrate_step
|
||||
每个 unit 用 node_search 召回已有 digest 节点
|
||||
决定 CREATE / CORROBORATE / REFINE / CORRECT
|
||||
|
||||
dream_topics_step
|
||||
写 daily/2026-05-18/interests.yaml
|
||||
|
||||
dream_finish_step
|
||||
checkpoint 成功处理的 daily 输入
|
||||
```
|
||||
|
||||
本场景中的产物:
|
||||
|
||||
```text
|
||||
digest/
|
||||
└── wiki/
|
||||
├── 嘉能可.md
|
||||
├── 钴.md
|
||||
└── 三元正极.md
|
||||
```
|
||||
|
||||
示例 `digest/wiki/钴.md`:
|
||||
|
||||
```markdown
|
||||
---
|
||||
name: 钴
|
||||
description: 锂电正极材料关键原料,主产区刚果(金)
|
||||
tags: [新能源, 原料, 钴]
|
||||
description: 锂电正极材料关键原料,主产区集中于刚果(金)
|
||||
---
|
||||
|
||||
所属领域:: [[新能源]]
|
||||
下游产品:: [[三元正极]]
|
||||
downstream_product:: [[digest/wiki/三元正极.md]]
|
||||
producer:: [[digest/wiki/嘉能可.md]]
|
||||
source_event:: [[daily/2026-05-18/2026-05-18-close.md]]
|
||||
|
||||
# 钴
|
||||
|
||||
## 供给端
|
||||
主要生产商 [[嘉能可]],产能集中于刚果(金)。
|
||||
嘉能可三季度钴产量同比下滑 18%。
|
||||
derived_from:: [[daily/2026-05-18/session_001]]
|
||||
嘉能可三季度钴产量同比下滑 18%,需要继续跟踪供给收缩对价格的影响。
|
||||
|
||||
## 政策风险
|
||||
刚果(金)矿权政策变化,可能影响 KFM 矿运营。
|
||||
derived_from:: [[daily/2026-05-18/session_001]]
|
||||
刚果(金)矿权政策变化可能影响 KFM 矿运营,需联动跟踪洛阳钼业。
|
||||
```
|
||||
|
||||
---
|
||||
注意:wikilink 是字面路径语义,推荐写完整 vault-relative 路径和 `.md` 扩展名。ReMe 不会自动把 `[[钴]]` 解析成某个文件。
|
||||
|
||||
#### Day 2(周二):宁德时代调研
|
||||
### Day 2:调研信息补充已有节点
|
||||
|
||||
王分析师参加宁德时代调研会后,和 Agent 聊调研要点:
|
||||
王分析师参加宁德时代调研:
|
||||
|
||||
```
|
||||
> 宁德今年全面切换 9 系高镍三元,钴用量还会继续降……
|
||||
> 产能利用率 85%,比上季度高 5 个点……
|
||||
```text
|
||||
宁德今年全面切换 9 系高镍三元,钴用量还会继续降。
|
||||
产能利用率 85%,比上季度高 5 个点。
|
||||
```
|
||||
|
||||
auto-memory 写入 `daily/2026-05-19/session_001.md`。
|
||||
|
||||
**Day 2 夜间 auto-dream** 处理这份 session:
|
||||
- **Phase 1**:提取「宁德时代高镍切换」(wiki)、「宁德时代产能利用率」(wiki)
|
||||
- **Phase 2**:
|
||||
- 「宁德时代高镍切换」→ 搜索到 `digest/wiki/三元正极.md` 已存在高镍化内容 → 决策 **REFINE**,补充"宁德 9 系切换"作为具体案例,并新建 `digest/wiki/宁德时代.md`
|
||||
- 「产能利用率」→ 无匹配 → 写入 `digest/wiki/宁德时代.md`(已存在,追加章节)
|
||||
|
||||
Day 2 结束时图谱新增节点和边:
|
||||
`auto_memory` 写入:
|
||||
|
||||
```text
|
||||
daily/2026-05-19/ningde-research.md
|
||||
```
|
||||
|
||||
`auto_dream date=2026-05-19` 时:
|
||||
|
||||
- `dream_extract_step` 提取“宁德高镍三元切换”“宁德产能利用率”。
|
||||
- `dream_integrate_step` 用 `node_search` 在 `digest/` 内召回 `digest/wiki/三元正极.md` 和 `digest/wiki/钴.md`。
|
||||
- Agent 对 `三元正极.md` 做 `REFINE`,把宁德 9 系切换作为案例写入。
|
||||
- Agent `CREATE` 或更新 `digest/wiki/宁德时代.md`。
|
||||
|
||||
此时图谱逐步长成:
|
||||
|
||||
```text
|
||||
digest/wiki/
|
||||
├── 嘉能可.md
|
||||
├── 钴.md
|
||||
├── 三元正极.md ← REFINE:新增宁德 9 系切换案例
|
||||
└── 宁德时代.md ← CREATE:含高镍切换 + 产能数据
|
||||
relates_to:: [[三元正极]]
|
||||
relates_to:: [[钴]]
|
||||
├── 三元正极.md # REFINE: 高镍低钴趋势 + 宁德案例
|
||||
└── 宁德时代.md # CREATE: 产能利用率 + 9 系切换
|
||||
```
|
||||
|
||||
### Day 5:用户检索“锂电上下游”
|
||||
|
||||
王分析师问:
|
||||
|
||||
```text
|
||||
帮我分析一下锂电相关上下游。
|
||||
```
|
||||
|
||||
Agent 调用:
|
||||
|
||||
```bash
|
||||
reme search query="锂电 上下游 三元 正极 钴 宁德" limit=5
|
||||
```
|
||||
|
||||
`search` 返回 chunk 正文、行号、分数,以及命中文件的 outlinks/inlinks 目录。默认配置下结果来自 BM25 + 图展开。
|
||||
|
||||
检索结果形态:
|
||||
|
||||
```text
|
||||
========== digest/wiki/钴.md:8-20 [score=0.0148 keyword=3.7112] ==========
|
||||
# 钴
|
||||
## 供给端
|
||||
嘉能可三季度钴产量同比下滑 18%...
|
||||
|
||||
outlinks:
|
||||
-> digest/wiki/三元正极.md name="三元正极" via predicate=downstream_product
|
||||
-> digest/wiki/嘉能可.md name="嘉能可" via predicate=producer
|
||||
inlinks:
|
||||
<- digest/wiki/三元正极.md name="三元正极" via predicate=upstream_material
|
||||
|
||||
========== digest/wiki/三元正极.md:5-18 [score=0.0139 keyword=3.2017] ==========
|
||||
...
|
||||
```
|
||||
|
||||
Agent 可以只看邻居目录就拼出产业链骨架;需要细节时,再调用:
|
||||
|
||||
```bash
|
||||
reme read path=digest/wiki/宁德时代.md
|
||||
reme traverse path=digest/wiki/钴.md depth=2 direction=both
|
||||
```
|
||||
|
||||
最终答复:
|
||||
|
||||
```text
|
||||
锂电链条可以分三段:
|
||||
1. 上游原料:钴,供给集中于刚果(金),嘉能可是核心生产商,洛阳钼业 KFM 矿需要跟踪政策影响。
|
||||
2. 中游材料:三元正极,高镍低钴路线持续推进。
|
||||
3. 下游电池:宁德时代已切换 9 系高镍三元,验证下游需求方向。
|
||||
|
||||
这条结论分别来自 2026-05-18 的盘后对话、嘉能可三季报资源笔记和 2026-05-19 宁德调研记录。
|
||||
```
|
||||
|
||||
### Proactive:读取当天兴趣主题
|
||||
|
||||
`auto_dream` 会写:
|
||||
|
||||
```text
|
||||
daily/2026-05-18/interests.yaml
|
||||
```
|
||||
|
||||
示例:
|
||||
|
||||
```yaml
|
||||
date: 2026-05-18
|
||||
topic_count: 3
|
||||
diversity_days: 7
|
||||
topics:
|
||||
- title: 刚果(金)矿权政策对钴供给的影响
|
||||
reason: 用户当天多次提到 KFM 矿和钴价风险
|
||||
keywords: [钴, 刚果金, 洛阳钼业, KFM]
|
||||
paths:
|
||||
- daily/2026-05-18/2026-05-18-close.md
|
||||
```
|
||||
|
||||
调用:
|
||||
|
||||
```bash
|
||||
reme proactive date=2026-05-18
|
||||
```
|
||||
|
||||
`proactive` Job 返回 `interests.yaml` 中的 topics 和可选 YAML 原文。
|
||||
|
||||
### 场景价值
|
||||
|
||||
- 分析师只负责看资料和表达判断,ReMe 把事实落到 daily,把长期概念沉淀到 digest。
|
||||
- `node_search` 让 dream 先找已有 digest 再写,避免同一概念每天新建一个文件。
|
||||
- `search` 的图展开让 Agent 先看结构再读正文,减少上下文浪费。
|
||||
- 所有结论都落在 Markdown 中,可用普通编辑器审计。
|
||||
|
||||
## 场景二:研发 Agent 的跨会话程序化记忆
|
||||
|
||||
**主角**:张研发,长期在 Claude Code、AgentScope 或其他 Agent 中处理项目问题。
|
||||
|
||||
**痛点**:同类 bug 多次出现,Agent 每次都从零开始排查;用户的代码风格、测试习惯、项目偏好只存在于当次对话里。
|
||||
|
||||
### 第一次会话:构建卡死
|
||||
|
||||
用户说:
|
||||
|
||||
```text
|
||||
pnpm build 卡在 92%,CPU 不高,内存涨得很快。
|
||||
```
|
||||
|
||||
Agent 排查过程:
|
||||
|
||||
```text
|
||||
1. 清缓存,无效。
|
||||
2. 升级 terser 插件,无效。
|
||||
3. 发现 fork-ts-checker 内存不足。
|
||||
4. 设置 NODE_OPTIONS=--max-old-space-size=8192 后通过。
|
||||
```
|
||||
|
||||
`auto_memory` 写入:
|
||||
|
||||
```text
|
||||
reme_session/dialog/build-oom-2026-03-10.jsonl
|
||||
daily/2026-03-10/build-oom-2026-03-10.md
|
||||
```
|
||||
|
||||
`auto_dream` 后生成:
|
||||
|
||||
```text
|
||||
digest/
|
||||
├── procedure/
|
||||
│ └── typescript-build-oom.md
|
||||
└── personal/
|
||||
└── code-style.md
|
||||
```
|
||||
|
||||
示例 `digest/procedure/typescript-build-oom.md`:
|
||||
|
||||
```markdown
|
||||
---
|
||||
name: TypeScript 项目构建 OOM 排查路径
|
||||
description: build 卡住且内存上涨时,优先检查类型检查进程内存
|
||||
---
|
||||
|
||||
#### Day 3(周三):亿纬电话会 + 洛阳钼业跟踪
|
||||
source_event:: [[daily/2026-03-10/build-oom-2026-03-10.md]]
|
||||
related_preference:: [[digest/personal/code-style.md]]
|
||||
|
||||
两场对话产生两份 session。夜间 auto-dream 逐个处理:
|
||||
# TypeScript 项目构建 OOM 排查路径
|
||||
|
||||
- `session_001.md`(亿纬电话会)→ Phase 2 搜到 `宁德时代.md`、`三元正极.md` → CREATE `digest/wiki/亿纬锂能.md`,并在 `三元正极.md` 上 CORROBORATE 高镍趋势
|
||||
- `session_002.md`(洛阳钼业跟踪)→ Phase 2 搜到 `钴.md` → REFINE `钴.md`,补充洛阳钼业 KFM 矿最新动态;CREATE `digest/wiki/洛阳钼业.md`
|
||||
## 症状
|
||||
构建卡在后段,CPU 不高但内存持续上涨。
|
||||
|
||||
Day 3 结束时图谱:
|
||||
## 优先路径
|
||||
1. 检查 fork-ts-checker 或类型检查子进程是否 OOM。
|
||||
2. 先尝试 `NODE_OPTIONS=--max-old-space-size=8192`。
|
||||
3. 清缓存和升级压缩插件只有在有明确证据时再做。
|
||||
|
||||
```
|
||||
digest/wiki/
|
||||
├── 嘉能可.md
|
||||
├── 洛阳钼业.md ← CREATE
|
||||
├── 钴.md ← REFINE:补充洛阳钼业信息
|
||||
│ relates_to:: [[嘉能可]], [[洛阳钼业]], [[三元正极]]
|
||||
├── 三元正极.md ← CORROBORATE:亿纬佐证
|
||||
│ relates_to:: [[钴]], [[宁德时代]], [[亿纬锂能]]
|
||||
├── 宁德时代.md
|
||||
└── 亿纬锂能.md ← CREATE
|
||||
## 已知无效路径
|
||||
- 单纯删除 `.cache` 未解决 2026-03-10 的问题。
|
||||
- 升级 terser 插件未解决 2026-03-10 的问题。
|
||||
```
|
||||
|
||||
每个节点都是**当天 dream 从一份 daily 文件中提取并整合的结果**,不存在跨天"聚合"——跨文件的关联通过 Phase 2 的 search 自然发现已有 digest,从而把新信息写入正确的位置。
|
||||
示例 `digest/personal/code-style.md`:
|
||||
|
||||
```markdown
|
||||
---
|
||||
name: 用户代码风格偏好
|
||||
description: 用户在开发任务中反复表达的工程偏好
|
||||
---
|
||||
|
||||
#### Day 5(周五):用户主动检索
|
||||
# 用户代码风格偏好
|
||||
|
||||
王分析师准备组会要讲新能源板块,主动问 Agent:
|
||||
## 注释
|
||||
用户不喜欢解释代码字面含义的注释,只接受解释 WHY 或复杂约束的注释。
|
||||
|
||||
> **"帮我分析一下锂电相关上下游"**
|
||||
|
||||
Agent 调用 ReMe 的 `search` Job,走向量 + BM25 + RRF 融合检索,命中已有的 digest 节点,并通过渐进式展开获取上下游全貌:
|
||||
|
||||
**第一跳——直接命中 chunk 全文 + 评分**:
|
||||
|
||||
```
|
||||
digest/wiki/钴.md:5-22 [score=0.0234 vector=0.0156 keyword=0.0078]
|
||||
# 钴 / ## 供给端
|
||||
主要生产商嘉能可、洛阳钼业,产能集中于刚果(金)……
|
||||
|
||||
digest/wiki/三元正极.md:10-30 [score=0.0211 vector=0.0148 keyword=0.0063]
|
||||
# 三元正极 / ## 高镍低钴路线
|
||||
2026 年起主流厂商加速 9 系产品,宁德已全面切换……
|
||||
|
||||
digest/wiki/宁德时代.md:1-20 [score=0.0193 vector=0.0135 keyword=0.0058]
|
||||
digest/wiki/嘉能可.md:5-30 [score=0.0167 vector=0.0117 keyword=0.0050]
|
||||
digest/wiki/洛阳钼业.md:1-22 [score=0.0152 vector=0.0106 keyword=0.0046]
|
||||
## 测试
|
||||
用户偏好针对风险点写聚焦测试,不喜欢大范围无关重构。
|
||||
```
|
||||
|
||||
**第二跳——展开 wikilink 邻居目录(只有标题,不展开正文)**:
|
||||
### 第二次会话:相似问题快速召回
|
||||
|
||||
```
|
||||
digest/wiki/钴.md 的邻居:
|
||||
outlinks (3):
|
||||
→ digest/wiki/三元正极.md name="三元正极" description="高镍低钴技术路线" via predicate=下游产品
|
||||
→ digest/wiki/嘉能可.md name="嘉能可" description="全球钴业巨头" via predicate=relates_to
|
||||
→ digest/wiki/洛阳钼业.md name="洛阳钼业" description="KFM 矿运营商" via predicate=relates_to
|
||||
inlinks (2):
|
||||
← daily/2026-05-18/session_001.md name="盘后对话" via plain
|
||||
← daily/2026-05-19/session_001.md name="宁德调研" via plain
|
||||
六周后用户问:
|
||||
|
||||
digest/wiki/三元正极.md 的邻居:
|
||||
outlinks (2):
|
||||
→ digest/wiki/宁德时代.md name="宁德时代" description="全球动力电池龙头" via predicate=relates_to
|
||||
→ digest/wiki/钴.md name="钴" description="锂电正极关键原料" via predicate=relates_to
|
||||
inlinks (1):
|
||||
← digest/wiki/亿纬锂能.md name="亿纬锂能" description="动力电池厂商" via predicate=relates_to
|
||||
```text
|
||||
vite build 也卡在打包阶段,是同一类问题吗?
|
||||
```
|
||||
|
||||
**第 N 跳——Agent 按需深入**:Agent 看过目录后,决定展开 `亿纬锂能.md` 的正文获取补充信息,调用 `read` Job 拉取。
|
||||
Agent 先调用:
|
||||
|
||||
Agent 基于检索结果**直接回复**王分析师:
|
||||
```bash
|
||||
reme search query="vite build 卡住 内存 上涨 TypeScript OOM" limit=5
|
||||
```
|
||||
|
||||
> "锂电产业链分三段:上游钴矿(嘉能可、洛阳钼业,刚果金集中)、中游三元正极(高镍化加速)、下游电池厂(宁德/亿纬)。这周你提到的事件分别落在:嘉能可三季报 → 上游产能收缩;高镍化趋势 → 中游路线切换;宁德 9 系切换 → 下游需求验证。"
|
||||
命中:
|
||||
|
||||
```text
|
||||
digest/procedure/typescript-build-oom.md
|
||||
daily/2026-03-10/build-oom-2026-03-10.md
|
||||
```
|
||||
|
||||
Agent 回复可以直接跳过低价值路径:
|
||||
|
||||
```text
|
||||
上次类似问题是 TypeScript 类型检查进程 OOM。建议优先检查构建阶段的内存和类型检查子进程,
|
||||
先试 `NODE_OPTIONS=--max-old-space-size=8192`。上次清缓存和升级压缩插件都没有解决。
|
||||
```
|
||||
|
||||
### 场景价值
|
||||
|
||||
- `digest/procedure/` 保存“怎么做”和“哪些路径无效”,让 Agent 复用排查经验。
|
||||
- `digest/personal/` 保存用户偏好,让 Agent 跨会话遵守同一工程风格。
|
||||
- 原始对话仍在 `reme_session/dialog/`,daily 记录可追溯,digest 只是长期提炼结果。
|
||||
|
||||
## 场景三:个人第二大脑
|
||||
|
||||
**主角**:李工。日常和 Agent 聊工作、读书、家庭安排、跑步训练和旅行计划。
|
||||
|
||||
**痛点**:普通聊天记录按时间堆叠,三个月后只能全文搜索,很难回答“上次 Alice 推荐的那本书是什么”“我为什么改了训练计划”这类联想式问题。
|
||||
|
||||
### 日常输入
|
||||
|
||||
李工的一天产生:
|
||||
|
||||
```text
|
||||
daily/2026-04-20/
|
||||
├── lunch-with-alice.md
|
||||
├── running-plan.md
|
||||
└── frontend-design-review.md
|
||||
```
|
||||
|
||||
`auto_dream` 抽取到:
|
||||
|
||||
```text
|
||||
digest/
|
||||
├── personal/
|
||||
│ ├── alice.md
|
||||
│ └── exercise-preferences.md
|
||||
├── procedure/
|
||||
│ └── frontend-review-checklist.md
|
||||
└── wiki/
|
||||
└── deep-work.md
|
||||
```
|
||||
|
||||
示例:
|
||||
|
||||
```markdown
|
||||
---
|
||||
name: Alice
|
||||
description: 用户朋友,常推荐阅读材料
|
||||
---
|
||||
|
||||
#### Day 7:图谱已经长出层次
|
||||
recommended_book:: [[digest/wiki/deep-work.md]]
|
||||
source_event:: [[daily/2026-04-20/lunch-with-alice.md]]
|
||||
|
||||
经过一周每天的 auto-dream 逐文件处理,图谱自然生长出来:
|
||||
# Alice
|
||||
|
||||
```
|
||||
┌─────────────┐
|
||||
┌────────►│ 锂电 │◄────────┐
|
||||
│ └──────┬──────┘ │
|
||||
│ upstream │ │ upstream
|
||||
│ │ 下游产品 │
|
||||
┌───────┴──────┐ ▼ ┌──────┴──────┐
|
||||
│ 钴 │ ┌─────────┐ │ 锂 │
|
||||
│ (刚果金产区) │◄──┤ 原料 ├────►│ (盐湖产区) │
|
||||
└───────┬──────┘ └────┬────┘ └─────────────┘
|
||||
│ relates_to │ relates_to
|
||||
▼ ▼
|
||||
┌──────────────┐ ┌──────────────┐
|
||||
│ 嘉能可 │ │ 三元正极 │◄── 高镍化趋势
|
||||
│ 洛阳钼业 │ └──────┬───────┘
|
||||
└──────────────┘ │ relates_to
|
||||
▼
|
||||
┌──────────────┐
|
||||
│ 宁德时代 │ ← Day 2 调研
|
||||
│ 亿纬锂能 │ ← Day 3 电话会
|
||||
└──────────────┘
|
||||
## 阅读推荐
|
||||
2026-04-20 午餐时推荐过一本关于注意力和深度工作的书。
|
||||
```
|
||||
|
||||
**没有一个节点是凭空编造的**——每条边对应笔记里的一句 `relates_to:: [[X]]` 或 `derived_from:: [[daily/...]]`,每个节点点开就是 Markdown,每段内容都能追溯到原始 daily 事件。图谱不是一次性生成的,而是每天 dream 一点、链接一点,渐进生长出来的。
|
||||
### 一次联想式回忆
|
||||
|
||||
---
|
||||
用户问:
|
||||
|
||||
### ReMe 在这个场景下的核心价值
|
||||
```text
|
||||
上次 Alice 推荐的那本讲注意力的书叫什么?
|
||||
```
|
||||
|
||||
分析师只负责"看 + 说",知识图谱自己长出来:
|
||||
Agent 可以先搜:
|
||||
|
||||
- **auto-memory** 把每次对话实时写入当天日记
|
||||
- **auto-dream** 每天逐文件执行 Extract → Integrate 管线,先搜已有 digest 再决策(CREATE / CORROBORATE / REFINE / CORRECT),知识卡片渐进生长
|
||||
- **auto-link** 是 dream 写入的副产品——`derived_from::` 溯源 + `relates_to::` 概念互联,图谱随每次 dream 自动变密
|
||||
- **混合检索 + 渐进展开** 让 Agent 先看骨架再决定深入哪个节点,不把 Top-K 全文塞进上下文
|
||||
```bash
|
||||
reme search query="Alice 推荐 注意力 书 深度" limit=5
|
||||
```
|
||||
|
||||
命中:
|
||||
|
||||
```text
|
||||
digest/personal/alice.md
|
||||
outlinks:
|
||||
-> digest/wiki/deep-work.md via predicate=recommended_book
|
||||
daily/2026-04-20/lunch-with-alice.md
|
||||
```
|
||||
|
||||
再读:
|
||||
|
||||
```bash
|
||||
reme read path=digest/wiki/deep-work.md
|
||||
```
|
||||
|
||||
最终答复:
|
||||
|
||||
```text
|
||||
是《深度工作》。记录显示 Alice 在 2026-04-20 午餐时推荐过,
|
||||
你后来把它归到注意力和工作方法主题下。
|
||||
```
|
||||
|
||||
### 场景价值
|
||||
|
||||
- daily 保留“当时发生了什么”。
|
||||
- digest/personal 记录人、偏好、长期关系。
|
||||
- digest/wiki 记录书、概念、主题。
|
||||
- wikilink 把“人 -> 书 -> 主题 -> 原始事件”串起来,比单纯按时间翻聊天记录更接近人的回忆方式。
|
||||
|
|
|
|||
|
|
@ -1,275 +0,0 @@
|
|||
# Watch Loop Step 重构计划
|
||||
|
||||
## 背景
|
||||
|
||||
当前 `index_update_loop`、`resource_watch_loop`、`digest_watch_loop` 都是同一种范式:
|
||||
|
||||
1. 启动时扫描已有文件变化。
|
||||
2. 用一组 step 处理扫描出来的变化。
|
||||
3. 进入持续监听。
|
||||
4. 持续监听到变化后,再用同一组 step 处理变化。
|
||||
|
||||
也就是说,初始化扫描和持续监听只是变化来源不同,后续更新逻辑应该共享。
|
||||
|
||||
现在的问题是这个范式没有被显式建模:
|
||||
|
||||
- `index_update_loop` 初始化和监听都走 `update_index_step`,基本一致。
|
||||
- `resource_watch_loop` 初始化和监听都走 `update_catalog_step + foreach_dispatch_step`,基本一致。
|
||||
- `digest_watch_loop` 初始化走 `update_catalog_step`,但监听阶段只走 `log_changes_step`,导致 live changes 不更新 `file_catalog`。
|
||||
- `watch_changes_step` 同时负责监听和 dispatch 下游逻辑,职责偏重。
|
||||
- `update_index_step` 和 `update_catalog_step` 内部有较多重复的变化分桶、结果收集、删除、持久化逻辑。
|
||||
|
||||
## 目标
|
||||
|
||||
重构后希望形成统一模型:
|
||||
|
||||
```text
|
||||
change producer:
|
||||
init_changes_step # 初始化,一次性产生 changes 并 dispatch
|
||||
watch_changes_step # 持续监听,持续产生 changes
|
||||
|
||||
change handlers:
|
||||
update_index_step
|
||||
update_catalog_step
|
||||
foreach_dispatch_step
|
||||
log_changes_step
|
||||
channel_notify_step # 后续可选
|
||||
```
|
||||
|
||||
核心原则:
|
||||
|
||||
- producer 只负责产生 `context["changes"]`。
|
||||
- handler 只负责消费 `context["changes"]`。
|
||||
- 初始化和持续监听都通过 `BaseStep.dispatch_steps(...)` 调用 handler。
|
||||
- `init_changes_step` 和 `watch_changes_step` 显式配置同一组 `dispatch_steps`,让范式直接可见。
|
||||
|
||||
## 配置设计
|
||||
|
||||
不新增 job 级 `change_steps`。每个 producer step 自己声明 `dispatch_steps`,初始化 producer 和持续监听 producer 配同一组 handler。
|
||||
|
||||
配置精简约定:
|
||||
|
||||
- `init_changes_step.recursive` 和 `watch_changes_step.recursive` 默认就是 `true`,配置中不再显式写。
|
||||
- `update_index_step` / `update_catalog_step` 的 `persist` 语义统一为默认 `true`,配置中不再显式写。
|
||||
- 只有当某个 loop 需要关闭递归或关闭持久化时,才显式写 `recursive: false` / `persist: false`。
|
||||
|
||||
### index_update_loop
|
||||
|
||||
```yaml
|
||||
index_update_loop:
|
||||
backend: background
|
||||
watch_dirs: [daily_dir, digest_dir, resource_dir]
|
||||
watch_suffixes: [md, jsonl]
|
||||
steps:
|
||||
- backend: init_changes_step
|
||||
store: file_store
|
||||
dispatch_steps: [update_index_step]
|
||||
- backend: watch_changes_step
|
||||
dispatch_steps: [update_index_step]
|
||||
```
|
||||
|
||||
### resource_watch_loop
|
||||
|
||||
```yaml
|
||||
resource_watch_loop:
|
||||
backend: background
|
||||
watch_dirs: [resource_dir]
|
||||
watch_suffixes: [md, txt, json, jsonl, csv, yaml, html]
|
||||
dispatch_job: auto_resource
|
||||
steps:
|
||||
- backend: init_changes_step
|
||||
store: file_catalog
|
||||
dispatch_steps: [update_catalog_step, foreach_dispatch_step]
|
||||
- backend: watch_changes_step
|
||||
dispatch_steps: [update_catalog_step, foreach_dispatch_step]
|
||||
```
|
||||
|
||||
### digest_watch_loop
|
||||
|
||||
```yaml
|
||||
digest_watch_loop:
|
||||
backend: background
|
||||
watch_dirs: [daily_dir, digest_dir]
|
||||
watch_suffixes: [md]
|
||||
steps:
|
||||
- backend: init_changes_step
|
||||
store: file_catalog
|
||||
dispatch_steps: [update_catalog_step, log_changes_step]
|
||||
- backend: watch_changes_step
|
||||
dispatch_steps: [update_catalog_step, log_changes_step]
|
||||
```
|
||||
|
||||
这样三个 loop 都统一成:
|
||||
|
||||
```text
|
||||
startup:
|
||||
scan changes
|
||||
dispatch handlers
|
||||
|
||||
runtime:
|
||||
watch changes
|
||||
dispatch same handlers
|
||||
```
|
||||
|
||||
## Step 拆分
|
||||
|
||||
### 1. BaseStep dispatch 能力
|
||||
|
||||
把 dispatch 能力沉到 `BaseStep`,所有 producer step 共享:
|
||||
|
||||
- `normalize_dispatch_steps(dispatch_step, dispatch_steps)`
|
||||
- `dispatch_steps(dispatch_steps, **kwargs)`
|
||||
|
||||
这样 `init_changes_step` 和 `watch_changes_step` 都不需要各自实现 registry 查询、step 实例化和 context 透传。
|
||||
|
||||
`dispatch_steps` 支持两种形式:
|
||||
|
||||
```yaml
|
||||
dispatch_steps: [update_catalog_step, log_changes_step]
|
||||
```
|
||||
|
||||
也支持给单个 handler 传参数:
|
||||
|
||||
```yaml
|
||||
dispatch_steps:
|
||||
- backend: update_catalog_step
|
||||
- backend: some_step
|
||||
option: value
|
||||
```
|
||||
|
||||
### 2. init_changes_step
|
||||
|
||||
新增 `init_changes_step`,替代现有两个初始化扫描 step:
|
||||
|
||||
- `scan_store_changes_step`
|
||||
- `scan_catalog_changes_step`
|
||||
|
||||
参数:
|
||||
|
||||
```yaml
|
||||
store: file_catalog | file_store
|
||||
dispatch_steps: [...]
|
||||
```
|
||||
|
||||
职责:
|
||||
|
||||
- 根据 `watch_dirs` / `watch_suffixes` 收集磁盘文件。
|
||||
- 根据 `store` 和目标状态源比较。
|
||||
- 生成统一格式的 `context["changes"]`。
|
||||
- 如果有变化,调用 `BaseStep.dispatch_steps(...)` 执行 handler。
|
||||
|
||||
输出格式:
|
||||
|
||||
```python
|
||||
[
|
||||
{"change": "added", "path": "/abs/path/to/file.md"},
|
||||
{"change": "modified", "path": "/abs/path/to/file.md"},
|
||||
{"change": "deleted", "path": "/abs/path/to/file.md"},
|
||||
]
|
||||
```
|
||||
|
||||
### 3. watch_changes_step
|
||||
|
||||
保留监听职责,弱化业务 dispatch 职责。
|
||||
|
||||
职责:
|
||||
|
||||
- 根据 `watch_dirs` / `watch_suffixes` 建立文件监听。
|
||||
- 对每个 debounced batch 生成同样格式的 `changes`。
|
||||
- 调用 `BaseStep.dispatch_steps(...)` 执行 handler。
|
||||
|
||||
### 4. update_index_step / update_catalog_step
|
||||
|
||||
第二阶段再精简。
|
||||
|
||||
它们现在重复逻辑包括:
|
||||
|
||||
- 解析 `added` / `modified` / `deleted`。
|
||||
- 判断文件是否存在。
|
||||
- 收集 per-path result。
|
||||
- 删除旧记录。
|
||||
- upsert 新记录。
|
||||
- persist。
|
||||
- 写 response。
|
||||
|
||||
建议抽内部基类,例如:
|
||||
|
||||
```python
|
||||
class ChangeApplyStep(BaseStep):
|
||||
async def parse_added_or_modified(self, path): ...
|
||||
async def upsert_items(self, items): ...
|
||||
async def delete_paths(self, rel_paths): ...
|
||||
async def dump_target(self): ...
|
||||
```
|
||||
|
||||
然后:
|
||||
|
||||
- `UpdateCatalogStep` 只实现 `stat -> FileNode`,写 `file_catalog`。
|
||||
- `UpdateIndexStep` 只实现 `chunk_file -> FileNode + chunks`,写 `file_store`。
|
||||
|
||||
这一步可以在 `init_changes_step` 落地后做,降低一次性改动风险。
|
||||
|
||||
## 实施顺序
|
||||
|
||||
当前落地状态:
|
||||
|
||||
- Phase 1 已完成:`BaseStep.dispatch_steps(...)`、`init_changes_step`、默认持久化、默认配置精简已落地。
|
||||
- Phase 2 已完成:`digest_watch_loop` 的初始化和监听都执行 `update_catalog_step + log_changes_step`。
|
||||
- 兼容旧 backend 不保留:`scan_store_changes_step` / `scan_catalog_changes_step` 已删除。
|
||||
- `reindex` 已改为 `clear_store_step + init_changes_step(store=file_store, dispatch_steps=[update_index_step])`。
|
||||
- Phase 3 已完成一层:`update_catalog_step` 和 `update_index_step` 已合并到 `update_changes.py`,
|
||||
并抽出 `ChangeApplyStep` 复用 added/modified/deleted、upsert/delete/persist 模板逻辑。
|
||||
|
||||
### Phase 1:统一范式
|
||||
|
||||
1. 把 dispatch 能力沉到 `BaseStep`。
|
||||
2. 新增 `init_changes_step`。
|
||||
3. 将 `update_index_step` 和 `update_catalog_step` 的 `persist` 默认值统一为 `true`。
|
||||
4. 修改 `default.yaml` 里的三个 loop:
|
||||
- 初始化阶段统一使用 `init_changes_step`。
|
||||
- `init_changes_step` 和 `watch_changes_step` 配置相同的 `dispatch_steps`。
|
||||
5. `watch_changes_step` 保留 `dispatch_step` 到 `dispatch_steps` 的轻量兼容。
|
||||
6. 验证三个 loop 的启动扫描和 live watch 都会执行同一条 handler pipeline。
|
||||
|
||||
### Phase 2:修正 digest_watch_loop 语义
|
||||
|
||||
`digest_watch_loop` 的 live changes 应该更新 `file_catalog`,因此初始化和监听阶段都应配置同一组 `dispatch_steps`:
|
||||
|
||||
```yaml
|
||||
dispatch_steps: [update_catalog_step, log_changes_step]
|
||||
```
|
||||
|
||||
如果后续要通知 channel,可以追加:
|
||||
|
||||
```yaml
|
||||
- backend: channel_notify_step
|
||||
```
|
||||
|
||||
### Phase 3:精简 update 类 step
|
||||
|
||||
1. 抽 `ChangeApplyStep` 基类或 helper 函数。
|
||||
2. 让 `update_index_step` 和 `update_catalog_step` 只保留各自差异逻辑。
|
||||
3. 保持外部行为不变:
|
||||
- 输入仍然是 `context["changes"]`。
|
||||
- 输出仍然写 `response.answer` 和 `response.success`。
|
||||
- `persist` 语义不变。
|
||||
|
||||
## 验证点
|
||||
|
||||
最少需要覆盖这些场景:
|
||||
|
||||
- `index_update_loop` 启动扫描新增文件,会更新 `file_store`。
|
||||
- `index_update_loop` live 新增/修改/删除文件,会更新 `file_store`。
|
||||
- `resource_watch_loop` 启动扫描新增文件,会更新 `file_catalog` 并触发 `auto_resource`。
|
||||
- `resource_watch_loop` live 新增文件,会更新 `file_catalog` 并触发 `auto_resource`。
|
||||
- `digest_watch_loop` 启动扫描新增/修改/删除文件,会更新 `file_catalog`。
|
||||
- `digest_watch_loop` live 新增/修改/删除文件,也会更新 `file_catalog`。
|
||||
- `changes` 为空时,`init_changes_step` 不应执行 handler,也不应报错。
|
||||
|
||||
## 预期收益
|
||||
|
||||
- 三个 background loop 的结构统一。
|
||||
- 初始化扫描和持续监听的处理逻辑完全复用。
|
||||
- `digest_watch_loop` 不再出现启动和 live 语义不一致。
|
||||
- `watch_changes_step` 和 `init_changes_step` 共享 `BaseStep` dispatch 能力。
|
||||
- 后续新增日志、channel notification、auto dream 等 handler 时,初始化和监听两处使用同一组 `dispatch_steps`。
|
||||
Loading…
Add table
Reference in a new issue